

學習 / 實作
LLM 機制實驗(四):前綴改了,舊 KV Cache 還能繼續用嗎?
llm / 理解 · 機制拆解
三種子、六條件,比較錯誤重用與帶鍵校驗的前綴快取;數值相同也不代表允許跨作用域共享。
這篇之後,已經有了哪些結果?
保留本文發表時的結論與下一步構想;以下是已發布的後續內容,不代表所有侷限皆已解決。
繼續探索
繼續探索
瀏覽統計暫不可用
本文目錄 7
上一輪已經驗證:在同一組輸入、權重、位置與掩碼下,增量 KV Cache 可以與完整因果計算保持一致。那麼,讀者回到聊天介面,把前面一句話改了,再繼續提問,原來的快取還能使用嗎?
風險在於快取不是原文的複製品。它是特定計算條件下形成的中間表示。輸入形狀沒變、快取長度沒變,不意味著這些表示仍然有效。
本篇保留上一輪的未訓練教學網路,只增加一個前綴快取倉庫。三個固定種子、六種條件共 18 個案例,對比無條件重用、帶鍵校驗重用和新鮮重算。沒有呼叫 Agnes,也沒有測語言回答能力。
1. 快取的身份不只是八個 Token
前綴固定為 Token ID 1 到 8,後綴為 9 到 12。網路為兩層、單頭、維度 16、詞表大小 32,使用 float64、正弦絕對位置和 tanh 殘差;沒有 tokenizer、訓練、FFN 或 layer norm。
重用時真正需要保持的條件包括:前綴 Token ID、模型權重、位置規則、窗口策略、實現版本,以及應用允許的作用域。本例用以下結構作為鍵:
wanted = (
    scope,
    signature(model, window),
    tuple(int(x) for x in prefix),
)
signature 哈希已有注意力原始碼、維度、層數、窗口、位置規則標籤,以及 embedding 和每層 Q/K/V 權重的形狀、類型與內容。後綴不進入前綴鍵:相同前綴繼續不同問題,正是可以重用的場景。
這個小網路可以負擔整份權重哈希。生產系統不應在每次請求時重新掃描大模型權重,應采用可信、不可變的模型修訂標識,並包含實際影響前綴計算的適配器、位置與快取配置。本例沒有實現那套部署機制。
2. 命中、未命中分別做什麼
remember 從倉庫自己的輸入計算快取,呼叫者不能直接塞入一份任意 K/V。容量固定為兩個條目,按插入順序淘汰;這是 FIFO,不宣稱 LRU。
繼續生成時先驗證 Token 類型,再查鍵。這個順序很重要:若先轉整數再判斷,浮點 ID 可能意外與整數 ID 共享鍵。
model.inputs(prefix, np.arange(len(prefix)))
model.inputs(suffix, np.arange(len(prefix), len(prefix) + len(suffix)))
match = next((e for e in reversed(self.entries) if e[:3] == wanted), None)
model.reset()
if match:
    out, _ = model.chunk(suffix, cache=match[3], window=window)
    return out, dict(reused=True, projected_rows=model.projected_rows)
out, _ = model.chunk(list(prefix) + list(suffix), window=window)
return out[-len(suffix):], dict(reused=False, projected_rows=model.projected_rows)未命中不是異常,而是重新計算完整輸入,再取後綴表示。這個版本要求整個前綴精確匹配,不查最長公共前綴,也沒有分頁快取、磁盤持久化或跨進程共享。
3. 六種條件在運行前固定
三個種子為 7、19、41。每種條件都拿相同條件下的完整因果計算作為參考,而不是拿最初那份結果作為所有案例的“正確答案”。
| 條件 | 相對存入時的變化 | 應否重用 |
|---|---|---|
| same-prefix | 無變化 | 是 |
| edited-prefix | 第三個前綴 ID 改為 20 | 否 |
| different-weights | 首層 WK 的一個元素加 0.5 | 否 |
| different-window | 完整注意力改為窗口 4 | 否 |
| different-scope | reader-a 改為 reader-b | 否 |
| new-suffix | 後綴改為 20 到 23 | 是 |
無條件基線始終重用最初前綴的快取,但使用當前模型與窗口繼續後綴。它模擬一個很容易寫出來的錯誤:認為“已有快取對象”就足夠了。
4. 錯誤重用產生了多大偏差
指標是四個後綴隱藏表示相對參考的最大絕對誤差,不是 Token 命中率、文本準確率或任務得分。
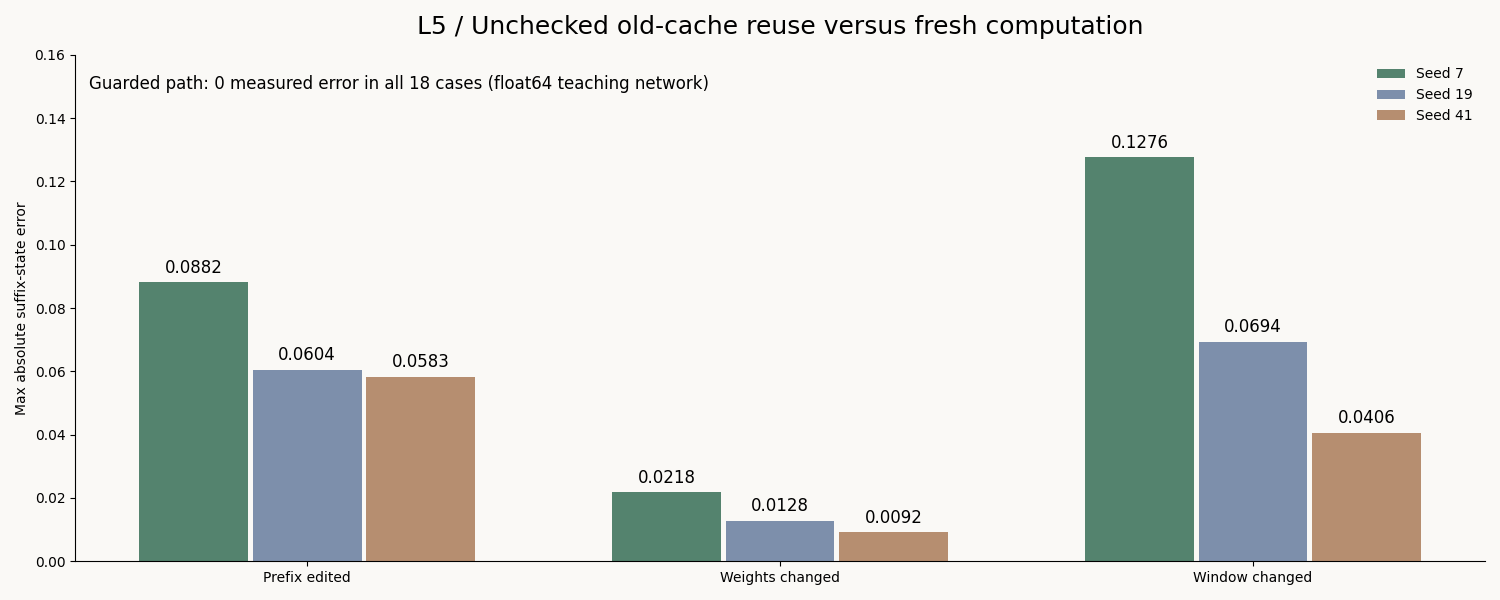
| 舊快取錯誤重用條件 | seed 7 | seed 19 | seed 41 |
|---|---|---|---|
| 修改前綴 | 0.088204 | 0.060447 | 0.058312 |
| 修改權重 | 0.021804 | 0.012761 | 0.009166 |
| 修改窗口 | 0.127578 | 0.069393 | 0.040604 |
帶鍵校驗的路徑在本機 float64 的 18 個案例中測得誤差均為 0,凍結容差為 1e-12。其中未命中路徑會完整重算,所以這部分一致性是退回正確路徑的結果;命中路徑才是在重用快取時與參考比較。不能據此承諾所有模型、精度與硬體都逐位相同。
相同前綴與新後綴兩個條件,繼續階段各投影 24 行;未命中條件投影 72 行。計數來自兩層各三種 Q/K/V 投影:命中為 4×2×3,重算為 12×2×3。它排除了事先建立快取、哈希與查找開銷,不能換算成三倍速度提升。
5. 數值相等卻必須拒絕重用的案例
different-scope 很容易被忽視。同樣的模型與輸入,即使無條件使用舊快取,結果誤差也為 0。為什麼帶鍵校驗仍然不命中?
因為數值正確性與應用允許重用的範圍是兩個問題。這個例子將 reader-a 與 reader-b 分區,僅用於說明快取鍵可以攜帶策略邊界;如果鍵只驗證張量相等,它完全看不到這類限制。
但這裡的 scope 是呼叫方傳入的普通字串,沒有賬號認證或權限綁定。它不構成已經驗證的多租戶隔離。生產系統必須從可信身份上下文派生作用域,而不是相信瀏覽器提交的名字;Python 對象內部條目也不是安全隔離區。
6. 從數組重新核對,而不是相信匯總文字
每個案例保存新鮮參考、無條件重用與帶校驗重用三個數組,共 54 個。獨立審計從這些數組重算 36 個誤差,核對 18 次重用決策、投影計數以及原始碼和資料哈希。
八個單元測試還檢查連續兩次從同一前綴接不同後綴是否互相污染、編輯前綴/權重/窗口/作用域後是否未命中、浮點 ID 是否被拒絕,以及容量淘汰和作用域輸入。這不是對所有快取策略的窮盡驗證。
從 hohoo-ai-lab 根目錄運行,重用上一輪依賴:
python -m pip install -r experiments/05-attention-lab/requirements.txt
python -m unittest discover -s experiments/06-prefix-cache -p "test_*.py"
python experiments/06-prefix-cache/run.py --out experiments/06-prefix-cache/evidence/MY-RUN
python experiments/06-prefix-cache/audit.py experiments/06-prefix-cache/evidence/MY-RUN
把實驗目錄換成新名字,保留現有歸檔。先預測 new-suffix 是否命中,再看結果;然後只改變一個前綴 ID,比較計數和誤差怎樣變化。
7. 這次給聊天應用留下的設計要求
編輯歷史消息應使受影響前綴失效;升級模型或更改注意力策略應產生新的快取身份;權限範圍變化需要獨立處理,不能依靠數值測試代替權限判斷。
關於不同快取實現和使用限制,可以繼續查閱 Transformers 官方 KV Cache 文檔。本篇運行的是獨立教學網路,沒有呼叫 Transformers 的快取實現。
下一步值得研究的是最長公共前綴重用及其邊界測試,但本輪沒有實現,也沒有測 GPU、時延或模型回答質量。當前結果回答的是一個更基礎的問題:什麼條件變化以後,已有中間計算不再有資格繼續被使用。
寫給未來的自己合上文章前,留下一點自己的理解。
你的私人學習便箋,只存在目前瀏覽器,不會上傳或公開。清理瀏覽器資料會遺失,請匯出留存。三種語言共用這篇文章的便箋。
下一篇已發布內容:LLM 機制實驗(五):改了歷史,能否只重算變化的後綴? →
目前學習位置
理解 / LLM
- ○ LLM機制實驗(三):快取只留四格,為什麼不等於重算四個Token?
- ○ LLM 機制實驗(四):前綴改了,舊 KV Cache 還能繼續用嗎?
- ○ LLM 機制實驗(五):改了歷史,能否只重算變化的後綴?
繼續探索
繼續探索
接下來,走哪條路?
- LLM機制實驗(二):KV Cache省掉了什麼,怎樣證明沒有算錯? →
逐前綴重算、逐Token快取與分塊快取三路對照,記錄誤差、投影行數和真實數組字節。
- LLM機制實驗(三):快取只留四格,為什麼不等於重算四個Token? →
用雙層滑動注意力區分絕對位置、快取槽位和歷史表示,展示兩種形狀正確卻計算錯誤的實現。
依據文章關聯與同主題已發布內容整理,不使用隨機推薦。