

學習 / 實作
LLM機制實驗(二):KV Cache省掉了什麼,怎樣證明沒有算錯?
llm / 理解 · 機制拆解
逐前綴重算、逐Token快取與分塊快取三路對照,記錄誤差、投影行數和真實數組字節。
這篇之後,已經有了哪些結果?
保留本文發表時的結論與下一步構想;以下是已發布的後續內容,不代表所有侷限皆已解決。
繼續探索
繼續探索
瀏覽統計暫不可用
本文目錄 7
KV Cache概念篇區分了聊天記錄與推理快取,但“可以復用”還缺一次實際驗算。本篇沿用因果掩碼實驗臺,讓三條計算路徑處理完全相同的24個Token,再逐位置比較結果。
這是未訓練雙層注意力網絡的機制實驗。沒有下載語言模型,沒有比較Agnes服務,也沒有把NumPy運算計數當成GPU速度。
1. 三條路徑必須輸出同一個對象
基準是一次完整因果前向計算得到的24×16表示矩陣。
| 路徑 | 每次輸入 | 取出的結果 |
|---|---|---|
| 逐前綴重算 | [0]、[0,1]……[0..23] |
每次最後一行 |
| 逐Token快取 | 一次輸入一個新Token | 新位置的一行 |
| 分塊快取 | 按5、3、7、9個Token輸入 | 每塊所有新位置 |
不能拿完整前向的“第一個Token輸出”和逐Token生成的“預測下一個Token”混比。本實驗直接比較同一位置的隱藏表示,不接取樣器,不做離散生成。
2. 每層都保存自己的K/V
第l層的新輸入先投影成新Q、K、V。將新K/V追加到該層舊快取,當前Q讀取允許的全部鍵,再把結果傳給下一層:
k = concatenate(old_k, new_k)
v = concatenate(old_v, new_v)
output = attention(new_q, k, v, query_positions, key_positions)
舊Q不參與新位置的查詢,因此本例不快取它。第二層的K/V來自第二層輸入,不能拿第一層快取冒充。程式碼為每層維護獨立的三元組:K、V、位置索引。
測試還檢查調用不會修改傳入的舊快取對象。這方便在不同候選分支上復用前綴;它並不實現記憶體高效的共享塊管理,本例使用數組拼接和複製。
3. 分塊輸入最容易寫錯的掩碼
已有5個Token快取,再輸入3個Token,新查詢的位置是5、6、7,鍵的位置是0到7。允許矩陣應為:
q5: 1 1 1 1 1 1 0 0
q6: 1 1 1 1 1 1 1 0
q7: 1 1 1 1 1 1 1 1
如果把新查詢錯誤編號成0、1、2,再畫一個左上角三角形,就會屏蔽大量本該可讀的舊上下文。它仍然能返回正常形狀的矩陣,甚至沒有NaN,所以只檢查張量形狀是不夠的。
凍結實驗中,正確分塊路徑最大誤差不超過 3.89e-16;故意用錯查詢偏移,三個種子的最大誤差分別為0.589838、0.739833、0.648703。反例明確檢出了這一類錯誤。
4. 記錄計算量,不冒充加速比
| 實際計數,24個Token、兩層 | 逐前綴重算 | 逐Token快取 |
|---|---|---|
| Q/K/V投影的輸入行數 | 1800 | 144 |
| 實際建立的注意力分數元素 | 9800 | 600 |
| 最終K/V數組有效負載 | 未跨步保存 | 12288 bytes |
投影行數可獨立計算:重算為 3×2×(1+…+24)=1800,快取為 3×2×24=144。分數元素計數分別為 2×Σt²=9800與 2×Σt=600。前者包含隨後被掩碼的元素,因為這個NumPy實現確實分配了方形分數矩陣。
K/V負載為 2(K/V)×2層×24位置×16維×8字節=12288。這裡只統計K/V數組的 nbytes,不含位置數組、臨時拼接、權重、Python對象和記憶體分配器開銷。
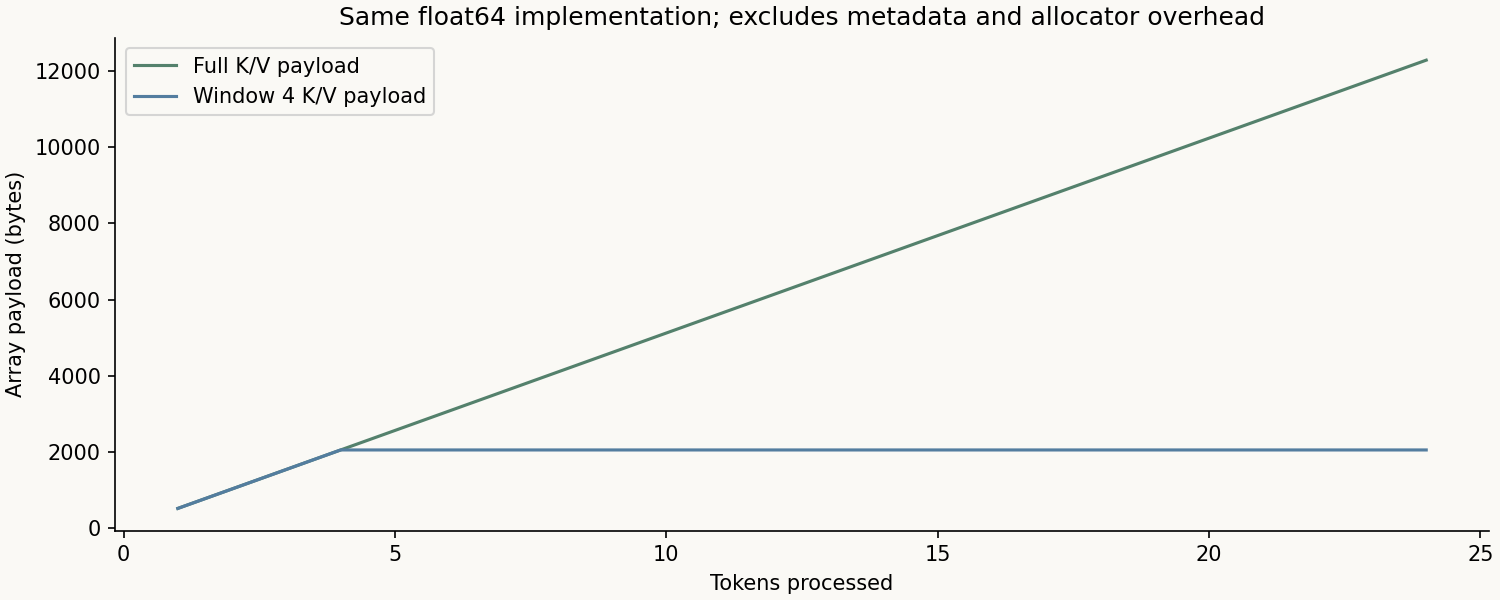
為什麼不直接說“快了12.5倍”?矩陣批量運算、快取複製、內核啟動與硬件並行都影響耗時;較少的計數不自動轉化成同倍數的墻鐘加速。本輪沒有將時間作為指標。
5. 等價到什麼程度
三個種子的逐前綴、逐Token和分塊路徑,與完整因果參考的最大絕對誤差均小於 1e-12。最大的逐Token差異為 5.55e-16,符合本次float64運算順序變化帶來的微小差異。
這不意味著量化、低精度、Dropout或不同注意力後端也會逐位相同。模型參數、輸入、位置處理和掩碼必須保持一致;前綴變動後,不能繼續無條件復用舊快取。
6. 運行與進一步驗證
python experiments/05-attention-lab/run.py --out experiments/05-attention-lab/evidence/my-cache-run
python experiments/05-attention-lab/audit.py experiments/05-attention-lab/evidence/my-cache-run
查看 arrays.npz里的 full / prefix / cached / chunked,比只看程式打印“通過”更有幫助。將分塊大小改成1、偶數或最後一塊不足長度,再對齊每個位置;單元測試已覆蓋多種長度和窗口。
接下來裁掉舊快取會引出更微妙的問題:快取只剩四個位置,是否就等價於只重新輸入最後四個Token?
通用快取機制可參閱 Hugging Face說明。本文計數對應自己的簡化實現,不是該庫的實測性能資料。
同方向繼續閱讀
寫給未來的自己合上文章前,留下一點自己的理解。
你的私人學習便箋,只存在目前瀏覽器,不會上傳或公開。清理瀏覽器資料會遺失,請匯出留存。三種語言共用這篇文章的便箋。
下一篇已發布內容:LLM機制實驗(三):快取只留四格,為什麼不等於重算四個Token? →
目前學習位置
理解 / LLM
- ○ LLM機制實驗(一):改動未來Token,前面的輸出應該變嗎?
- ○ LLM機制實驗(二):KV Cache省掉了什麼,怎樣證明沒有算錯?
- ○ LLM機制實驗(三):快取只留四格,為什麼不等於重算四個Token?
繼續探索
繼續探索
接下來,走哪條路?
- LLM機制實驗(一):改動未來Token,前面的輸出應該變嗎? →
從手算兩行Attention到雙層數值對照,驗證因果掩碼、Softmax與未來資訊泄漏。
- LLM機制實驗(三):快取只留四格,為什麼不等於重算四個Token? →
用雙層滑動注意力區分絕對位置、快取槽位和歷史表示,展示兩種形狀正確卻計算錯誤的實現。
依據文章關聯與同主題已發布內容整理,不使用隨機推薦。