

學習 / 實作
LLM機制實驗(一):改動未來Token,前面的輸出應該變嗎?
llm / 理解 · 機制拆解
從手算兩行Attention到雙層數值對照,驗證因果掩碼、Softmax與未來資訊泄漏。
這篇之後,已經有了哪些結果?
保留本文發表時的結論與下一步構想;以下是已發布的後續內容,不代表所有侷限皆已解決。
繼續探索
繼續探索
瀏覽統計暫不可用
本文目錄 6
以前的上下文位置對照從介面外部觀察模型。這一組文章換到計算內部:實現一個很小的注意力網絡,逐個檢查“哪些位置可以影響哪些位置”。
網絡沒有訓練,也不會生成有意義的語言。它使用32個離散ID、16維表示、兩個單頭注意力層,每層是 tanh(x + attention(x));位置使用絕對正弦編碼,計算為float64。沒有Tokenizer、FFN、歸一化、Dropout或Agnes請求。這裡驗證的是確定的計算關系,不是語言理解能力。
1. 一個能直接手算的注意力例子
先令Q和K全為0,V的兩行為 [2,4]、[6,8]。分數都是0,Softmax會對允許讀取的位置平均分配權重。
| 查詢行 | 允許的Key | 權重 | 輸出 |
|---|---|---|---|
| 位置0 | 0 | [1,0] |
[2,4] |
| 位置1 | 0、1 | [0.5,0.5] |
[4,6] |
第一行不能讀取第二行,這就是本例的因果要求。若沒有掩碼,兩行都會輸出 [4,6],位置0提前使用了未來值。測試 test_hand_attention 獨立固定了這組手算答案,避免只用兩個相似實現互相證明正確。
2. 掩碼必須作用在Softmax之前
scores = q @ k.T / np.sqrt(d)
allowed = key_positions[None, :] <= query_positions[:, None]
scores = np.where(allowed, scores, -np.inf)
ex = np.exp(scores - scores.max(axis=1, keepdims=True))
weights = ex / ex.sum(axis=1, keepdims=True)
output = weights @ v
被禁止位置的指數為0,再對剩余位置歸一化。如果先Softmax再把未來權重清零,而不重新歸一化,輸出尺度會改變。程式碼還拒絕“某一行所有位置都被屏蔽”,否則減去負無窮可能產生NaN。
減去每行最大值避免指數溢出;它不改變歸一化後的分布。測試另用很大的相同分數檢查有限結果和平均權重。這裡的 1/sqrt(d)縮放與“禁止未來位置”是不同作用,不應混成一句“掩碼讓注意力穩定”。
3. 凍結一個未來擾動實驗
輸入長24,tokens[i]=(7*i+3)%32。只將索引12到23的ID加1再取模,前12個輸入完全不動。分別運行因果掩碼和無掩碼版本,比較前12行最終表示的最大絕對坐標變化。
權重由固定種子7、19、41生成,材料和參數在運行前保存。沒有根據結果挑選“最好看”的種子。
| 權重種子 | 因果版本前12行變化 | 無掩碼前12行變化 |
|---|---|---|
| 7 | 0 | 0.139619 |
| 19 | 0 | 0.081980 |
| 41 | 0 | 0.328622 |
數字是隱藏表示的坐標差,不是正確率、置信度或損失值。三次0與因果結構一致;另外三個非零反例說明,這組輸入確實能檢出未來資訊泄漏,不是網絡碰巧對改動毫無反應。
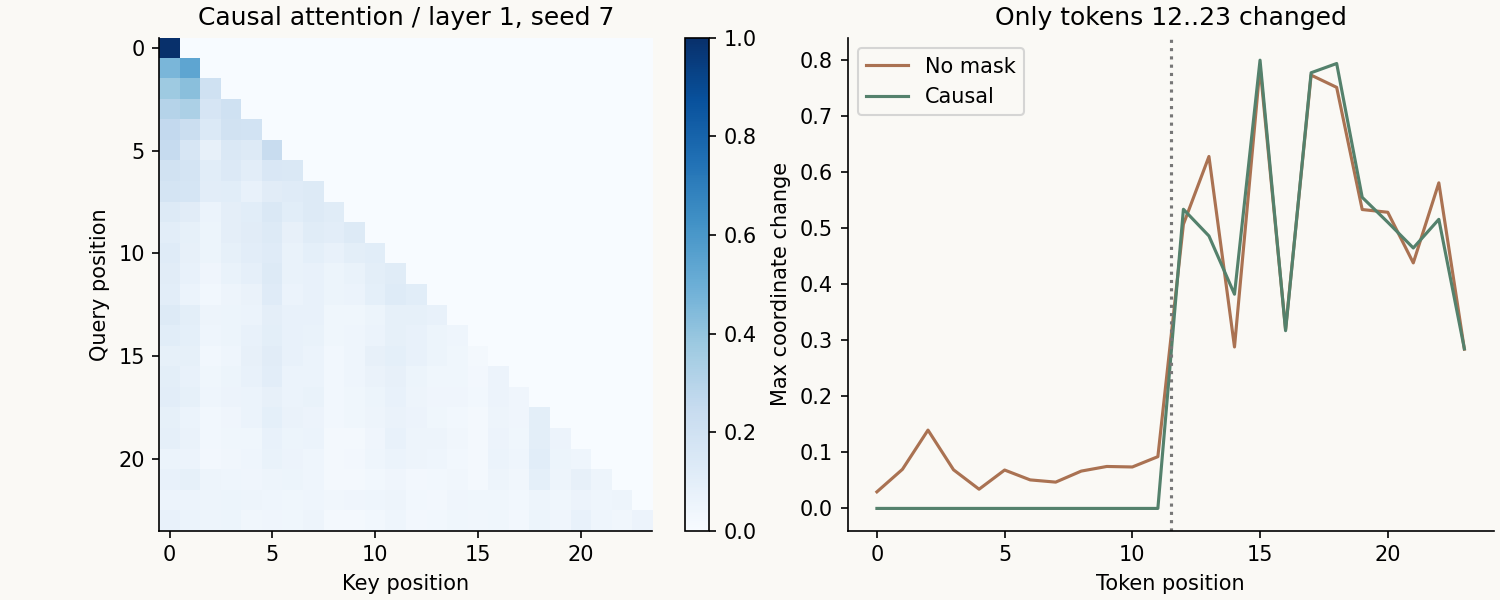
左圖是種子7第一層的實際權重,上三角為0。右圖比較完整雙層輸出,虛線右側才是被修改的位置。不能把右側出現變化誤認為因果掩碼失效:那些位置自己的輸入本來就變了。
4. 因果性如何穿過第二層
第一層位置i只依賴位置0到i。第二層位置i讀取這些位置的第一層表示,而它們也沒有讀取i之後的資訊。因此,在逐位置殘差和激活不混入未來的前提下,第二層仍是因果的。
這個推導有工程前提:位置編碼相同、參數相同、掩碼正確,且沒有額外的跨位置操作泄漏資訊。若訓練和推理使用不同掩碼,訓練中較低的損失可能只是看到了答案,而不是學會了預測。
本實驗沒有訓練損失,不能從圖上推導訓練收益;它提供的是一種能早期抓住實現錯誤的驗收方式。
5. 重現與檢查檔案
python -m unittest discover -s experiments/05-attention-lab -p "test_*.py"
python experiments/05-attention-lab/run.py --out experiments/05-attention-lab/evidence/my-run
python experiments/05-attention-lab/audit.py experiments/05-attention-lab/evidence/my-run依賴為NumPy2.2.6;本次Python3.12.14。9個測試方法包含36種種子/長度/窗口組合的分塊對照。arrays.npz保存48個具名數組,審計程式不導入網絡實現,而是用存檔矩陣重算27個誤差指標、掩碼結構和運算計數。
下一篇:KV Cache為什麼能復用舊表示。如果舊位置本來會讀取未來,那麼新Token出現後舊K/V也會變化,簡單快取就失去了等價依據。
通用注意力形式與因果遮罩背景見 Transformer原論文。本篇簡化網絡和全部數值來自配套實現,不聲稱重現原論文的機器翻譯結果。
同方向繼續閱讀
寫給未來的自己合上文章前,留下一點自己的理解。
你的私人學習便箋,只存在目前瀏覽器,不會上傳或公開。清理瀏覽器資料會遺失,請匯出留存。三種語言共用這篇文章的便箋。
下一篇已發布內容:LLM機制實驗(二):KV Cache省掉了什麼,怎樣證明沒有算錯? →
目前學習位置
理解 / LLM
- ○ KV Cache 拆解:多輪對話的歷史,為什麼還要再傳一遍?
- ○ LLM機制實驗(一):改動未來Token,前面的輸出應該變嗎?
- ○ LLM機制實驗(二):KV Cache省掉了什麼,怎樣證明沒有算錯?
繼續探索
繼續探索
接下來,走哪條路?
- LLM機制實驗(二):KV Cache省掉了什麼,怎樣證明沒有算錯? →
逐前綴重算、逐Token快取與分塊快取三路對照,記錄誤差、投影行數和真實數組字節。
- KV Cache 拆解:多輪對話的歷史,為什麼還要再傳一遍? →
從因果注意力推導 K/V 復用,用一個可計算的記憶體例子區分推理快取、前綴快取與聊天記錄。
- LLM機制實驗(三):快取只留四格,為什麼不等於重算四個Token? →
用雙層滑動注意力區分絕對位置、快取槽位和歷史表示,展示兩種形狀正確卻計算錯誤的實現。
依據文章關聯與同主題已發布內容整理,不使用隨機推薦。