

学习 / 实践
LLM机制实验(一):改动未来Token,前面的输出应该变吗?
llm / 理解 · 机制拆解
从手算两行Attention到双层数值对照,验证因果掩码、Softmax与未来信息泄漏。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 6
以前的上下文位置对照从接口外部观察模型。这一组文章换到计算内部:实现一个很小的注意力网络,逐个检查“哪些位置可以影响哪些位置”。
网络没有训练,也不会生成有意义的语言。它使用32个离散ID、16维表示、两个单头注意力层,每层是 tanh(x + attention(x));位置使用绝对正弦编码,计算为float64。没有Tokenizer、FFN、归一化、Dropout或Agnes请求。这里验证的是确定的计算关系,不是语言理解能力。
1. 一个能直接手算的注意力例子
先令Q和K全为0,V的两行为 [2,4]、[6,8]。分数都是0,Softmax会对允许读取的位置平均分配权重。
| 查询行 | 允许的Key | 权重 | 输出 |
|---|---|---|---|
| 位置0 | 0 | [1,0] |
[2,4] |
| 位置1 | 0、1 | [0.5,0.5] |
[4,6] |
第一行不能读取第二行,这就是本例的因果要求。若没有掩码,两行都会输出 [4,6],位置0提前使用了未来值。测试 test_hand_attention 独立固定了这组手算答案,避免只用两个相似实现互相证明正确。
2. 掩码必须作用在Softmax之前
scores = q @ k.T / np.sqrt(d)
allowed = key_positions[None, :] <= query_positions[:, None]
scores = np.where(allowed, scores, -np.inf)
ex = np.exp(scores - scores.max(axis=1, keepdims=True))
weights = ex / ex.sum(axis=1, keepdims=True)
output = weights @ v
被禁止位置的指数为0,再对剩余位置归一化。如果先Softmax再把未来权重清零,而不重新归一化,输出尺度会改变。代码还拒绝“某一行所有位置都被屏蔽”,否则减去负无穷可能产生NaN。
减去每行最大值避免指数溢出;它不改变归一化后的分布。测试另用很大的相同分数检查有限结果和平均权重。这里的 1/sqrt(d)缩放与“禁止未来位置”是不同作用,不应混成一句“掩码让注意力稳定”。
3. 冻结一个未来扰动实验
输入长24,tokens[i]=(7*i+3)%32。只将索引12到23的ID加1再取模,前12个输入完全不动。分别运行因果掩码和无掩码版本,比较前12行最终表示的最大绝对坐标变化。
权重由固定种子7、19、41生成,材料和参数在运行前保存。没有根据结果挑选“最好看”的种子。
| 权重种子 | 因果版本前12行变化 | 无掩码前12行变化 |
|---|---|---|
| 7 | 0 | 0.139619 |
| 19 | 0 | 0.081980 |
| 41 | 0 | 0.328622 |
数字是隐藏表示的坐标差,不是正确率、置信度或损失值。三次0与因果结构一致;另外三个非零反例说明,这组输入确实能检出未来信息泄漏,不是网络碰巧对改动毫无反应。
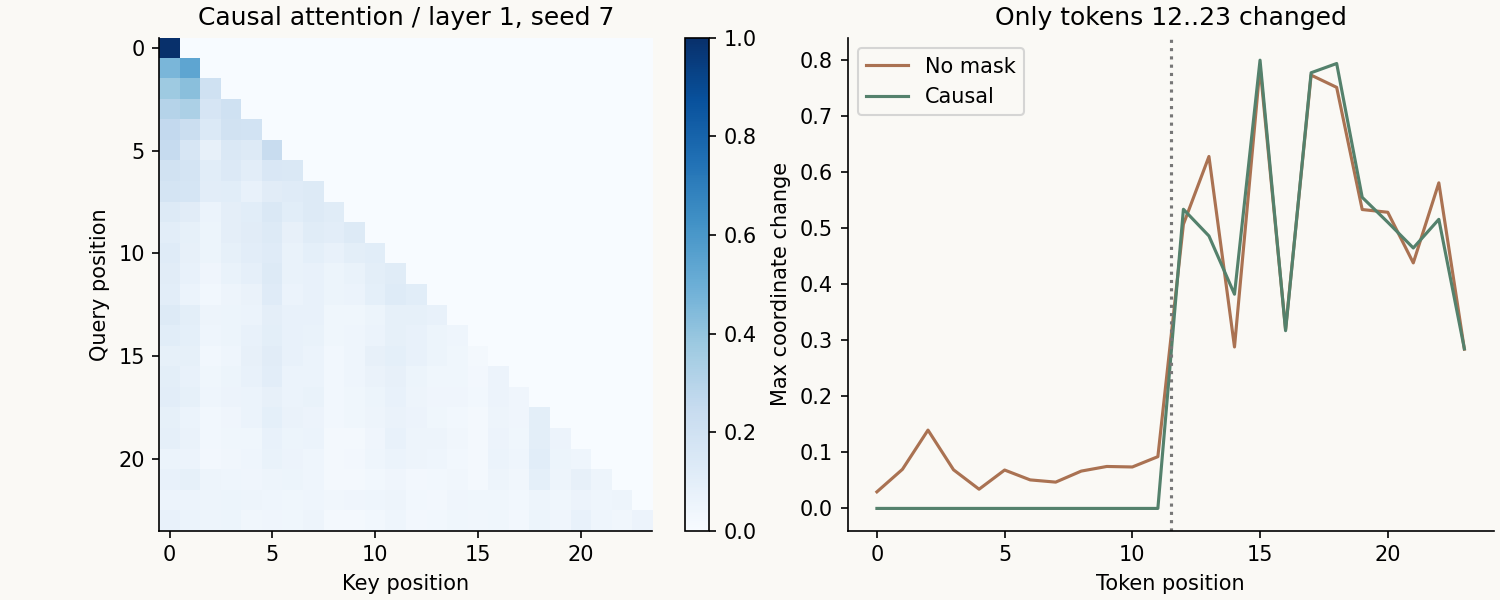
左图是种子7第一层的实际权重,上三角为0。右图比较完整双层输出,虚线右侧才是被修改的位置。不能把右侧出现变化误认为因果掩码失效:那些位置自己的输入本来就变了。
4. 因果性如何穿过第二层
第一层位置i只依赖位置0到i。第二层位置i读取这些位置的第一层表示,而它们也没有读取i之后的信息。因此,在逐位置残差和激活不混入未来的前提下,第二层仍是因果的。
这个推导有工程前提:位置编码相同、参数相同、掩码正确,且没有额外的跨位置操作泄漏信息。若训练和推理使用不同掩码,训练中较低的损失可能只是看到了答案,而不是学会了预测。
本实验没有训练损失,不能从图上推导训练收益;它提供的是一种能早期抓住实现错误的验收方式。
5. 复现与检查文件
python -m unittest discover -s experiments/05-attention-lab -p "test_*.py"
python experiments/05-attention-lab/run.py --out experiments/05-attention-lab/evidence/my-run
python experiments/05-attention-lab/audit.py experiments/05-attention-lab/evidence/my-run依赖为NumPy2.2.6;本次Python3.12.14。9个测试方法包含36种种子/长度/窗口组合的分块对照。arrays.npz保存48个具名数组,审计程序不导入网络实现,而是用存档矩阵重算27个误差指标、掩码结构和运算计数。
下一篇:KV Cache为什么能复用旧表示。如果旧位置本来会读取未来,那么新Token出现后旧K/V也会变化,简单缓存就失去了等价依据。
通用注意力形式与因果遮罩背景见 Transformer原论文。本篇简化网络和全部数值来自配套实现,不声称复现原论文的机器翻译结果。
同方向继续阅读
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
下一篇已发布内容:LLM机制实验(二):KV Cache省掉了什么,怎样证明没有算错? →
当前学习位置
理解 / LLM
- ○ KV Cache 拆解:多轮对话的历史,为什么还要再传一遍?
- ○ LLM机制实验(一):改动未来Token,前面的输出应该变吗?
- ○ LLM机制实验(二):KV Cache省掉了什么,怎样证明没有算错?
继续探索
继续探索
接下来,走哪条路?
- LLM机制实验(二):KV Cache省掉了什么,怎样证明没有算错? →
逐前缀重算、逐Token缓存与分块缓存三路对照,记录误差、投影行数和真实数组字节。
- KV Cache 拆解:多轮对话的历史,为什么还要再传一遍? →
从因果注意力推导 K/V 复用,用一个可计算的内存例子区分推理缓存、前缀缓存与聊天记录。
- LLM机制实验(三):缓存只留四格,为什么不等于重算四个Token? →
用双层滑动注意力区分绝对位置、缓存槽位和历史表示,展示两种形状正确却计算错误的实现。
依据文章关联与同主题已发布内容整理,不使用随机推荐。