

学习 / 实践
LLM机制实验(三):缓存只留四格,为什么不等于重算四个Token?
llm / 理解 · 机制拆解
用双层滑动注意力区分绝对位置、缓存槽位和历史表示,展示两种形状正确却计算错误的实现。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 7
缓存越积越大,一个自然的想法是只保留最近四个位置。但“保留四格”至少有三种实现:保留四份已经算好的K/V;把当前Token的位置重新编号;每次只把最后四个原始Token重新送进网络。
它们的内存和形状可能相近,计算意义却不同。本篇在上一轮缓存等价实验上只引入窗口限制,其余参数保持一致。
1. 窗口的定义必须写清楚
窗口W=4,包含当前Token。绝对位置i只能读取 i-3到i;序列开头不足四个位置时,读取已有部分。完整参考实现仍对全部输入计算,但每层每行按这个范围做掩码。
增量实现则维护每层K/V和它们的绝对位置。计算新Token时暂时把新K/V接在旧缓存后面,掩码屏蔽窗口外位置;计算完才保留最后四份。缓存槽位0可能对应绝对位置20,二者不能混用。
由于拼接,瞬时数组可能超过四格。最终K/V有效负载固定为2048 bytes,不代表整个进程或分配峰值只有这么大。
2. 正确窗口缓存与完整窗口参考一致
固定输入24个ID、两层16维float64注意力、种子7/19/41。按每个位置的16维最终表示计算最大绝对误差:
| 种子 | 正确窗口缓存 | 每次重置新Token位置 | 只重算最近四个原始Token |
|---|---|---|---|
| 7 | 4.996e-16 | 1.639644 | 0.322195 |
| 19 | 5.274e-16 | 1.581518 | 0.412958 |
| 41 | 3.331e-16 | 1.483657 | 0.391865 |
所有列都与“完整输入、每层使用相同滑动掩码”的参考比较。第一列在1e-12容差内;后两列是故意保留的错误或不同语义对照,不是模型能力差异。
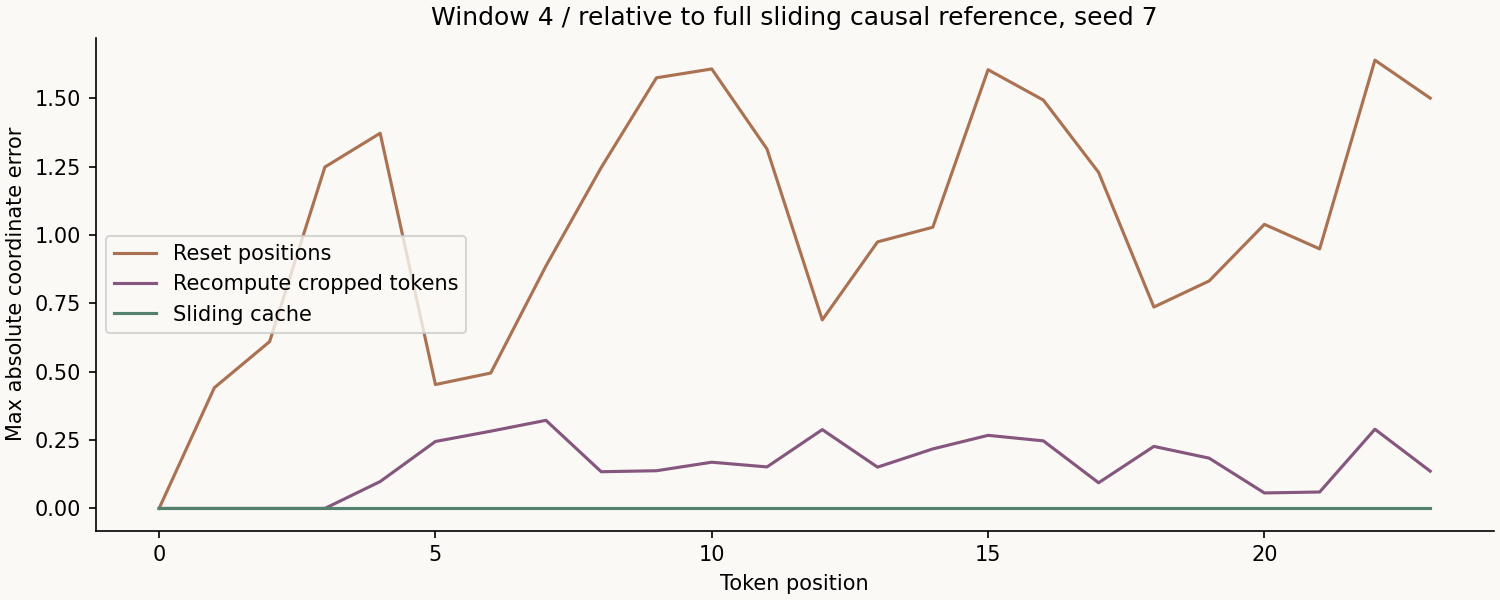
3. 第一个错误:把槽位当成位置
本实验使用加法式绝对正弦位置编码:input = embedding(token) + position(absolute_index)。当处理第20个Token时,即使缓存只有四格,它也不应重新变成位置0。
错误对照在每次单Token调用时都加入位置0的编码。注意力掩码仍使用正确的绝对索引,所以这个对照只改变输入的位置表示,不同时掺入“掩码也错了”的因素。
结果表明,本实现里重置位置会改变输出。这里没有实现RoPE,因此不能直接把数值推广到RoPE重定位或旋转缓存的方案;不同位置机制需要自己的等价性检查。
4. 第二个差别:上层缓存已经带着更早的信息
为了排除位置错误,裁剪重算对照仍给剩下的原始Token使用正确的绝对编号。即便如此,双层输出仍然不同。
假设位置20的窗口是17、18、19、20。第二层缓存中位置17的K/V,来自它在第一层计算好的表示;那个表示可能读过14、15、16、17。如果只重新输入17到20,位置17第一层已经看不到14到16,它的第二层K/V当然可能改变。
因此,一个两层、每层窗口四的位置依赖范围,可以比“最后四个原始Token”更长。缓存保存的是计算过的表示,不是原始文本的四格切片。这解释了为什么保持绝对位置仍不能让裁剪重算等价。
不能由此宣称滑动窗口保存了无限记忆。本例只有两层,信息经过有限的变换与窗口传播;更不能把坐标误差翻译成“模型遗忘了多少事实”。
5. 三个索引不要挤成一个变量
past = cache['next_position']
positions = np.arange(past, past + len(new_tokens))
# 每层拼接并按绝对位置做掩码。
cache['next_position'] = past + len(new_tokens)
# 存储裁剪不把 next_position 减回窗口大小。
工程上分别保留:已处理Token数量、每个缓存条目的绝对位置、当前数组槽位。序列长度可能增长,缓存长度保持上限,这不是矛盾。
单元测试覆盖窗口1、4和不裁剪,输入长度1、2、8、17,三种种子与分块输入,共36种组合。错误的窗口值、非法Token与全屏蔽查询会被拒绝。测试通过只约束这个简化实现;不保证其他架构具有相同性质。
6. 复现与可继续做的研究
python experiments/05-attention-lab/run.py --out experiments/05-attention-lab/evidence/my-window-run
python experiments/05-attention-lab/audit.py experiments/05-attention-lab/evidence/my-window-run
查看 sliding / sliding_cached / reset / cropped四组数组。最有价值的下一步不是继续加术语,而是换成明确版本的真实模型,研究它使用的位置机制与缓存策略,再分别验证数值误差、内存峰值和任务表现。
这次没有下载权重或发出在线请求。它与仍待授权的L1v3上下文干扰对照是两类工作,不能替代对Agnes回答行为的实测。通用缓存位置背景可参阅 Hugging Face缓存说明。
同方向继续阅读
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
下一篇已发布内容:LLM 机制实验(四):前缀改了,旧 KV Cache 还能继续用吗? →
当前学习位置
理解 / LLM
- ○ LLM机制实验(二):KV Cache省掉了什么,怎样证明没有算错?
- ○ LLM机制实验(三):缓存只留四格,为什么不等于重算四个Token?
- ○ LLM 机制实验(四):前缀改了,旧 KV Cache 还能继续用吗?
继续探索
继续探索
接下来,走哪条路?
- LLM机制实验(一):改动未来Token,前面的输出应该变吗? →
从手算两行Attention到双层数值对照,验证因果掩码、Softmax与未来信息泄漏。
- LLM机制实验(二):KV Cache省掉了什么,怎样证明没有算错? →
逐前缀重算、逐Token缓存与分块缓存三路对照,记录误差、投影行数和真实数组字节。
依据文章关联与同主题已发布内容整理,不使用随机推荐。