

学习 / 实践
LLM机制实验(二):KV Cache省掉了什么,怎样证明没有算错?
llm / 理解 · 机制拆解
逐前缀重算、逐Token缓存与分块缓存三路对照,记录误差、投影行数和真实数组字节。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 7
KV Cache概念篇区分了聊天记录与推理缓存,但“可以复用”还缺一次实际验算。本篇沿用因果掩码实验台,让三条计算路径处理完全相同的24个Token,再逐位置比较结果。
这是未训练双层注意力网络的机制实验。没有下载语言模型,没有比较Agnes服务,也没有把NumPy运算计数当成GPU速度。
1. 三条路径必须输出同一个对象
基准是一次完整因果前向计算得到的24×16表示矩阵。
| 路径 | 每次输入 | 取出的结果 |
|---|---|---|
| 逐前缀重算 | [0]、[0,1]……[0..23] |
每次最后一行 |
| 逐Token缓存 | 一次输入一个新Token | 新位置的一行 |
| 分块缓存 | 按5、3、7、9个Token输入 | 每块所有新位置 |
不能拿完整前向的“第一个Token输出”和逐Token生成的“预测下一个Token”混比。本实验直接比较同一位置的隐藏表示,不接采样器,不做离散生成。
2. 每层都保存自己的K/V
第l层的新输入先投影成新Q、K、V。将新K/V追加到该层旧缓存,当前Q读取允许的全部键,再把结果传给下一层:
k = concatenate(old_k, new_k)
v = concatenate(old_v, new_v)
output = attention(new_q, k, v, query_positions, key_positions)
旧Q不参与新位置的查询,因此本例不缓存它。第二层的K/V来自第二层输入,不能拿第一层缓存冒充。代码为每层维护独立的三元组:K、V、位置索引。
测试还检查调用不会修改传入的旧缓存对象。这方便在不同候选分支上复用前缀;它并不实现内存高效的共享块管理,本例使用数组拼接和复制。
3. 分块输入最容易写错的掩码
已有5个Token缓存,再输入3个Token,新查询的位置是5、6、7,键的位置是0到7。允许矩阵应为:
q5: 1 1 1 1 1 1 0 0
q6: 1 1 1 1 1 1 1 0
q7: 1 1 1 1 1 1 1 1
如果把新查询错误编号成0、1、2,再画一个左上角三角形,就会屏蔽大量本该可读的旧上下文。它仍然能返回正常形状的矩阵,甚至没有NaN,所以只检查张量形状是不够的。
冻结实验中,正确分块路径最大误差不超过 3.89e-16;故意用错查询偏移,三个种子的最大误差分别为0.589838、0.739833、0.648703。反例明确检出了这一类错误。
4. 记录计算量,不冒充加速比
| 实际计数,24个Token、两层 | 逐前缀重算 | 逐Token缓存 |
|---|---|---|
| Q/K/V投影的输入行数 | 1800 | 144 |
| 实际建立的注意力分数元素 | 9800 | 600 |
| 最终K/V数组有效负载 | 未跨步保存 | 12288 bytes |
投影行数可独立计算:重算为 3×2×(1+…+24)=1800,缓存为 3×2×24=144。分数元素计数分别为 2×Σt²=9800与 2×Σt=600。前者包含随后被掩码的元素,因为这个NumPy实现确实分配了方形分数矩阵。
K/V负载为 2(K/V)×2层×24位置×16维×8字节=12288。这里只统计K/V数组的 nbytes,不含位置数组、临时拼接、权重、Python对象和内存分配器开销。
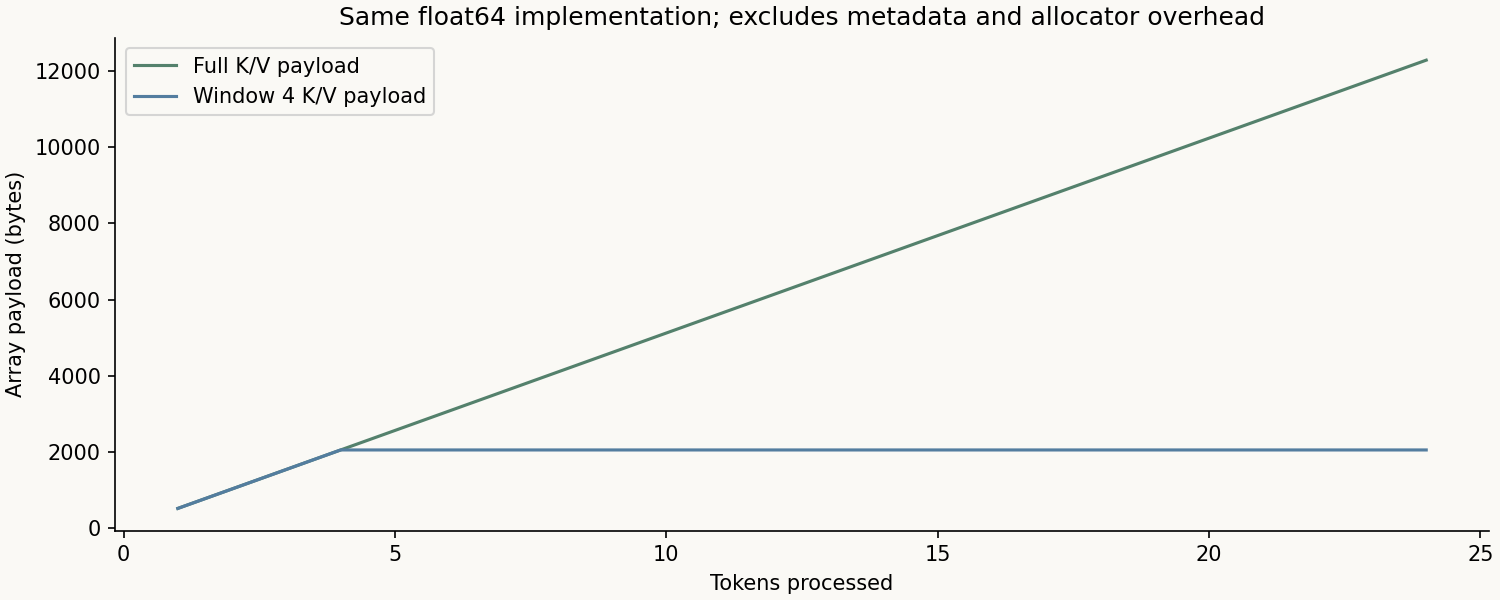
为什么不直接说“快了12.5倍”?矩阵批量运算、缓存复制、内核启动与硬件并行都影响耗时;较少的计数不自动转化成同倍数的墙钟加速。本轮没有将时间作为指标。
5. 等价到什么程度
三个种子的逐前缀、逐Token和分块路径,与完整因果参考的最大绝对误差均小于 1e-12。最大的逐Token差异为 5.55e-16,符合本次float64运算顺序变化带来的微小差异。
这不意味着量化、低精度、Dropout或不同注意力后端也会逐位相同。模型参数、输入、位置处理和掩码必须保持一致;前缀变动后,不能继续无条件复用旧缓存。
6. 运行与进一步验证
python experiments/05-attention-lab/run.py --out experiments/05-attention-lab/evidence/my-cache-run
python experiments/05-attention-lab/audit.py experiments/05-attention-lab/evidence/my-cache-run
查看 arrays.npz里的 full / prefix / cached / chunked,比只看程序打印“通过”更有帮助。将分块大小改成1、偶数或最后一块不足长度,再对齐每个位置;单元测试已覆盖多种长度和窗口。
接下来裁掉旧缓存会引出更微妙的问题:缓存只剩四个位置,是否就等价于只重新输入最后四个Token?
通用缓存机制可参阅 Hugging Face说明。本文计数对应自己的简化实现,不是该库的实测性能数据。
同方向继续阅读
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
下一篇已发布内容:LLM机制实验(三):缓存只留四格,为什么不等于重算四个Token? →
当前学习位置
理解 / LLM
- ○ LLM机制实验(一):改动未来Token,前面的输出应该变吗?
- ○ LLM机制实验(二):KV Cache省掉了什么,怎样证明没有算错?
- ○ LLM机制实验(三):缓存只留四格,为什么不等于重算四个Token?
继续探索
继续探索
接下来,走哪条路?
- LLM机制实验(一):改动未来Token,前面的输出应该变吗? →
从手算两行Attention到双层数值对照,验证因果掩码、Softmax与未来信息泄漏。
- LLM机制实验(三):缓存只留四格,为什么不等于重算四个Token? →
用双层滑动注意力区分绝对位置、缓存槽位和历史表示,展示两种形状正确却计算错误的实现。
依据文章关联与同主题已发布内容整理,不使用随机推荐。