

学习 / 实践
Java LLM 实践(七):引用是真的,为什么答案仍然不能通过?
RAG / 检索 · 工程案例
22 个固定配置案例,拆开引用存在、版本范围、字段支持与完整性,验证 Java 回答验收边界。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 7
上一轮的检索实验留下一个漏洞:引用的确出现在给模型的资料中,就说明答案有依据吗?
看一个具体例子。资料写着 read_timeout_ms=5000,回答却说超时是 2000,并把那句原文附在后面。文档存在、引文真实、格式正确,答案依然错了。生产环境与开发环境混用、旧版配置被当成新版,也会留下看起来很完整的引用。
这篇把问题缩小到一个能严格验收的 Java 配置问答契约。代码接收候选声明,返回经过核对的字段映射;22 个预先固定的案例里,仅检查引用存在会放过 10 个违规案例。它是生成回答之后的一道应用边界,不是通用自然语言事实核查器。
1. 把“有依据”拆成可以核对的条件
假设应用要查询 payments 服务、prod 环境、v2 修订的两个字段:读取超时和是否重试。教学注册表包含四份原创合成配置:
| 文档 | 服务 / 环境 / 修订 | read_timeout_ms | retry_enabled |
|---|---|---|---|
| prod-v2 | payments / prod / v2 | 5000 | false |
| prod-v1 | payments / prod / v1 | 2000 | true |
| dev-v2 | payments / dev / v2 | 12000 | true |
| billing-v2 | billing / prod / v2 | 5000 | false |
这些不是任何真实服务的配置。当前修订由受信任的请求指定,不能让候选回答自己选择“哪一版算当前”。默认提供前三份资料;另一个测试专门提供 billing 文档,验证数值相同也不能跨服务借用证据。
一次通过需要同时满足:文档确实提供过、引文确实存在、服务和环境匹配、修订匹配、字段在请求范围内、值一致、引文支持当前字段,且没有遗漏或重复声明。
2. 不接收一段自由回答再猜它有没有问题
本例的输入只有 claims,每条声明必须包含四个字符串。下面是完整的正例:
{
  "claims": [
    {
      "field": "read_timeout_ms",
      "value": "5000",
      "doc": "prod-v2",
      "quote": "read_timeout_ms=5000"
    },
    {
      "field": "retry_enabled",
      "value": "false",
      "doc": "prod-v2",
      "quote": "retry_enabled=false"
    }
  ]
}
没有独立的 answer 字段。否则可能出现“声明部分通过,自由回答里又加了一句相反结论”的绕过。成功后 UI 只根据 accepted 字段映射生成展示文本,不继续透传原始回答。
解析层使用已有 Gson 的 JsonReader,关闭宽松模式,并检查重复属性、未知属性、非字符串值、尾随 JSON。总输入上限为 8192 个 Java UTF-16 字符单元,单字段上限 2048,最多八条声明。这些是本例的输入边界,不是模型 Token 上限。
特别注意:JSON 对象中的重复键不能简单依靠普通 Map 反序列化后再检查,因为覆盖发生后已经看不到重复项。本例在读取属性时就拒绝它。
3. 真实引用仍然会失败的三种方式
第一种是值不一致。保留上面的引文,只把 value 改成 2000,结果是 VALUE_MISMATCH。原文真实性不能替代声明正确性。
第二种是范围不一致。引用 dev-v2 的 12000,即使值和引文完全相同,也会因为请求查的是 prod 而返回 SCOPE_MISMATCH。旧版 prod-v1 则返回 STALE_REVISION。
第三种是引文与字段无关。将第一条声明的引文改为同一资料中的 retry_enabled=false,引用检查仍然通过,但字段验收返回 QUOTE_NOT_SUPPORTING。
核心代码的顺序如下,完整实现见固定版本仓库:
if (!request.revision.equals(s.revision))
    return reject("STALE_REVISION", true);

String value = s.facts.get(field);
if (value == null || !value.equals(c.get("value")))
    return reject("VALUE_MISMATCH", true);

if (!(field + "=" + value).equals(c.get("quote")))
    return reject("QUOTE_NOT_SUPPORTING", true);

accepted.put(field, value);
这里故意使用严格的规范表示 field=value。5s 与 5000 不自动视为相同,也不接受同义改写。对于闭合配置表,这是可解释的取舍;对于普通文章问答,它过于严格,需要另一套有标注的语义支持评估。
4. 22 个案例实际留下了什么
案例和预期状态在运行前随代码冻结,分为 3 个正例和 19 个负例。正例覆盖完整回答、字段顺序交换,以及请求只需要一个字段的情况。负例覆盖范围、版本、值、证据、字段集合和输入语法。
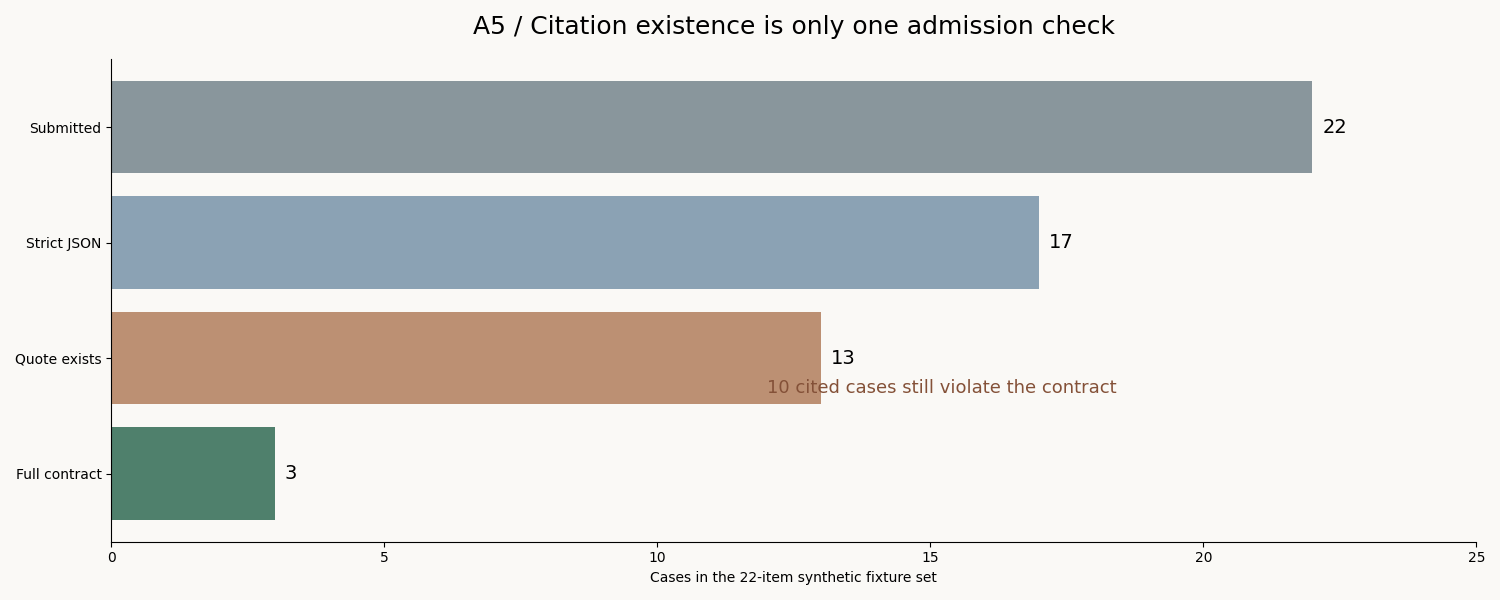
| 检查层 | 通过数量 | 仍然不能排除什么 |
|---|---|---|
| 严格 JSON | 17 / 22 | 合法格式里的错误声明 |
| 引用存在于已提供资料 | 13 / 22 | 旧修订、跨环境、无关引文、遗漏等 |
| 完整字段契约 | 3 / 22 | 注册表本身是否真实、可信、及时 |
完整契约的 22 个实际状态与冻结标签相符。这个分母是定向设计的测试集,不能写成“RAG 准确率 100%”。也没有进行模型生成、更大语料检索或有无 RAG 的在线对照。
另一个边界案例把资料中的一段指令式文字当成引文。它确实存在,所以引用基线接受;它不等于所需字段的规范事实,因此契约拒绝。程序始终把资料当数据,没有执行其中的指令。这只验证当前闭合结构的行为,不构成完整的提示注入防护证明。
5. 失败时不返回半份可用结果
如果第一个字段正确,第二个字段不正确,应该留下第一个字段吗?本例选择整次拒绝,accepted 为空。否则调用者可能把局部结果误当成完整答复。
成功结果则复制为排序后的不可修改 Map。重复声明返回 DUPLICATE_CLAIM,额外字段返回 UNREQUESTED_FIELD,遗漏返回 INCOMPLETE。这些状态帮助区分修复方向,但不会触发自动重试、自动修订请求版本或放宽校验。
这一策略适合“必须完整答复指定配置”的接口。产品如果需要部分回答,应明确设计字段级状态和缺失提示,而不是让失败结果意外泄漏出半份成功数据。
6. 如何复现和自己改出一个反例
需要 Java 8、Maven 和 Python 3;沿用 Gson 2.10.1。本次实际环境为 Java 8u171。进入 hohoo-ai-lab 仓库:
python demos/07-grounded-claims/run.py --out demos/07-grounded-claims/evidence/MY-RUN
python demos/07-grounded-claims/audit.py demos/07-grounded-claims/evidence/MY-RUN
Maven 不在 PATH 时,给 run.py 追加 --maven 与可执行文件路径。输出必须使用新目录,不能覆盖归档结果。manifest.json 记录冻结源码和输入,results.json 保存逐例状态,独立 Python 审计重算引用基线并核对标签、输出与哈希。
建议练习:先复制 fixtures,再只改正确案例的引文为另一个真实字段。运行前写下预测:引用基线应通过,完整契约应拒绝。然后把引用改回去、只改声明值,比较失败类型为何不同。不要为了让测试通过而改原始归档标签。
7. 下一道边界在哪里
这里最重要的假设是:请求范围和事实注册表由应用控制。若注册表写错了,本程序可以非常稳定地接受错误事实;若请求者无权读取某个环境,这个校验器也没有替代身份授权。
下一步仍沿用已有 RAG 实验:对普通句子建立“支持、矛盾、证据不足”的标注,再接入固定模型的成组对照。此次先解决结构化配置场景中可确定的部分,不把字符串一致性称为自然语言理解。
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
当前学习位置
检索 / RAG · 检索增强生成
- ○ Java LLM 实践(六):先验收检索证据,再谈RAG回答
- ○ Java LLM 实践(七):引用是真的,为什么答案仍然不能通过?
继续探索
继续探索
接下来,走哪条路?
- Java LLM 实践(六):先验收检索证据,再谈RAG回答 →
10篇原创合成资料、14个固定问题,手写BM25与引用边界;保留词汇失配和无答案题的误命中。
- Java LLM 实践(五):工具超时了,为什么任务还在执行? →
用白名单、严格参数、零队列与调用预算构建只读工具执行器,并复现取消不等于终止的边界。
依据文章关联与同主题已发布内容整理,不使用随机推荐。