

学习 / 实践
Java LLM 实践(八):流式回答断了,半句答案该不该进入历史?
AI 应用 / 构建 · 工程案例
22 个回环 HTTP 案例,验证 UTF-8、SSE 分帧、取消与异常结束,把逐步预览和完整历史提交分开。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 8
HTTP 200 已经返回,屏幕也显示了半句话。此时网络断开,这轮对话算成功吗?如果把半句话加入 messages,下一轮模型会把它当成已经说完的回答。一个显示层的小问题,就这样变成了上下文问题。
这一篇把前面整段 JSON 响应改成 SSE 文本流,但只做一件事:预览可以逐步更新,历史必须等完整结束后再提交。 22 个冻结案例通过本机真实 HTTP 连接执行:6 个完整结束,16 个异常或取消案例均保留原历史。这是协议与会话边界实验,没有调用 Agnes,也没有验证任何在线模型的流式兼容性。
先拆开四种边界
流式读取容易混淆四件事:网络一次读到了多少字节、解码出了多少字符、一个 SSE 事件何时结束、一轮回答是否已经完成。它们不是同一条边界。
| 层次 | 判断什么 | 常见错误 |
|---|---|---|
| 字节读取 | InputStream.read 返回了一段数据 |
把一次读取当成一个完整 Token 或 JSON |
| UTF-8 解码 | 跨读取保留未完成的多字节字符 | 每段单独 new String(bytes, UTF_8) |
| SSE 分帧 | 空行分隔事件,多行 data: 合并 |
每读到一行就交给 JSON 解析器 |
| 回答验收 | 结束原因和应用终止标记满足约定 | 把 HTTP 200、EOF 或可见文字当作成功 |
SSE 的换行、注释与多行 data 规则来自 WHATWG 规范。choices、finish_reason 和 [DONE] 属于本例采用的应用协议,不是 SSE 标准规定的字段。
为什么中文会在流里损坏
假设“你”的 UTF-8 字节跨过两次读取。第一段缺少剩余字节,此时单独解码可能产生替换字符;第二段再解码,也无法补回已经丢失的状态。不能靠增大缓冲区保证每次都恰好落在字符边界。
示例用一个持续存在的 InputStreamReader 承接字节流,拒绝非法 UTF-8:
Reader reader = new InputStreamReader(
    input,
    StandardCharsets.UTF_8.newDecoder()
        .onMalformedInput(CodingErrorAction.REPORT)
        .onUnmappableCharacter(CodingErrorAction.REPORT)
);
为了稳定复现,客户端包装器把每次批量读取上限限制为 1 或 7 字节。这控制的是读取粒度,不声称控制了 TCP 分包。服务端和操作系统仍可合并传输。
在同一份 one-byte.sse 上,逐字节独立解码的对照产生 13 个替换字符;持续解码器最终得到 你好,Java 🌱。这是固定输入的结果,不是中文网络故障发生率。1 字节上限路径记录 253 次读取,7 字节路径为 37 次,也不据此推断吞吐性能。
解析器什么时候才能交出一个事件
下列内容虽然分成两行 data:,仍然只有一个事件。解析时需要用换行连接两行值,遇到后面的空行才交给 JSON 层。
data: {
data: "choices":[{"index":0,"delta":{"content":"你好"},"finish_reason":null}]}
StreamReader 同时处理 LF、CRLF、单独 CR、开头的 BOM 和冒号注释。这里不会使用 id 自动恢复请求,也不会让 retry 启动隐式重连。重连涉及已经显示的内容如何去重、已经执行的副作用能否重复,不能作为解析器的小补丁偷偷加进去。
JSON 层拒绝重复字段、尾随内容与过深嵌套。文本层只接受单个 choices[0]、索引 0、role/content 增量以及可选用量帧。工具调用增量会被拒绝:工具参数需要另一套拼接和验收状态机,不能拿“文本能显示”替代“参数可以执行”。
预览与提交分开
本例的成功条件是:收到非空文本,收到 finish_reason: "stop",然后收到由空行正常结束的 [DONE] 事件。只有解析器按这个条件返回,调用方才向历史追加当前用户问题和完整回答。
// history initially contains the previous user/assistant pair.
String answer = reader.read(input, this::updatePreview);
// Reached only after successful protocol completion.
history.add("U:" + question);
history.add("A:" + answer);
示例片段表达调用顺序;仓库里的 Suite 用固定问题和列表实际验证这条边界。异常路径关闭连接,保留预览供界面解释,但不把预览转成正式回答。重试时重新提交问题,不能先在历史里留下重复的用户消息。
这是一轮请求内的提交边界,不是数据库事务,也没有并发会话锁。真实服务还要防止旧请求的完成回调写进已经切换的会话。
22 个案例实际发生了什么
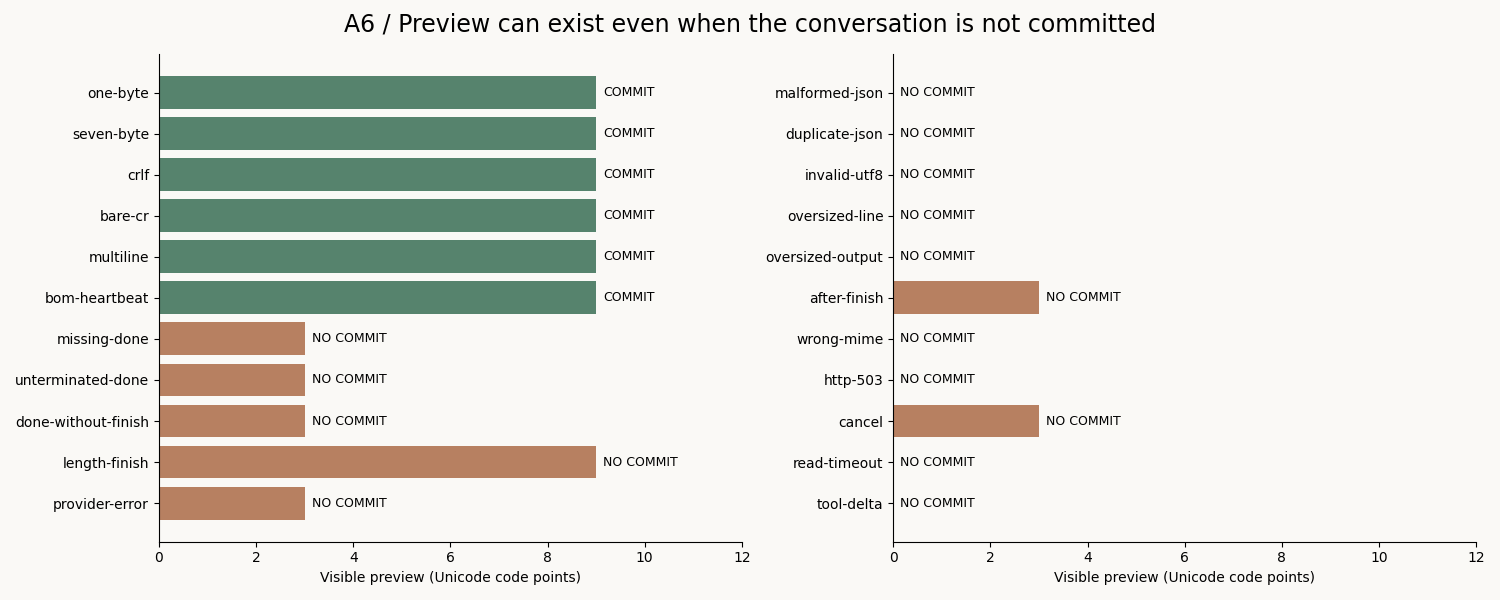
| 案例组 | 数量 | 观察到的结果 |
|---|---|---|
| 1/7 字节读取、三种换行、多行数据、BOM/心跳 | 6 | 完整回答相同,历史由 2 条变为 4 条 |
| 缺少 DONE、DONE 未以空行结束 | 2 | INCOMPLETE_STREAM,已有“你好,”也不提交 |
| 没有 stop 就 DONE、stop 后继续正文、工具增量 | 3 | PROTOCOL |
length 结束、服务端错误帧 |
2 | 分别为 INCOMPLETE_FINISH、PROVIDER_ERROR |
| 非法/重复 JSON、非法 UTF-8 | 3 | 解析失败,历史不变 |
| 行超限、输出超限 | 2 | LIMIT |
| 错误 MIME、HTTP 503 | 2 | 进入正文协议前拒绝 |
| 用户取消、读取超时 | 2 | CANCELLED、READ_TIMEOUT |
值得注意的是 length-finish:屏幕已经出现完整的测试字符串,仍然被拒绝。验收遵守结束原因,不能根据“看上去像一句完整话”猜测是否截断。
取消案例在预览达到 3 个 Java 字符单元时主动抛出取消信号;超时案例让服务端先发送响应头、再等待 400ms,而客户端读超时为 100ms。两者均没有提交历史。所有案例都保存原始 SSE、状态和历史长度,独立审计检查了固定标签、文件哈希和提交条件。
资源上限也是协议的一部分
示例限制单行 8,192、单事件 8,192、总输入 65,536、输出 4,096 个 Java UTF-16 字符单元;最多 256 个数据事件,JSON 深度不超过 16。图中预览长度使用 Unicode 码点计数,与 Java 的长度单位不同,emoji 尤其要注意。
字符处理期限为 2 秒,但检查只发生在读取字符之后。因此它不是能中断任意阻塞操作的严格总截止时间;连接与 socket 读取超时仍然分别设置。限长案例覆盖了行和输出上限,不能把这 22 个案例说成所有资源边界的穷尽测试。
如何复现和继续改
准备 Java 8、Maven、Python 3。Java 依赖只有现有 Gson 2.10.1;审计用 Python 标准库,图表才需要 Matplotlib。
python demos/08-streaming-boundary/run.py --out demos/08-streaming-boundary/evidence/MY-RUN
python demos/08-streaming-boundary/audit.py demos/08-streaming-boundary/evidence/MY-RUN
Maven 不在路径中时用 --maven 指定可执行文件;依赖已缓存时可用 --offline。输出目录必须是新的。归档采用 20261003-r2:首次尝试停在未固定的插件解析阶段,没有开始 HTTP 案例;改成仓库已有的固定版本插件后才完成实验。
建议先做两个小改动来理解边界:把 stop 改成 length,观察“能显示但不提交”;删掉 DONE 后最后一个空行,观察“终止文字出现了但事件未完整结束”。最后再接真实供应商协议,分别验证错误事件、用量帧和工具增量,不能直接把本地通过当成线上兼容。
这一轮得到的可用原则是:屏幕上的临时输出和下一轮请求的正式历史,应当有不同的生命周期。 后续需要补的是并发取消、请求身份与幂等重试,而不是给每个异常自动重发一次。
修复进展 · 2026-10-07
2026-10-07 修正:Demo08–10 增加 JSON 词法校验,三个示例各通过 53 项离线回归;运行脚本改用 Maven 参数列表,支持含空格目录。Demo10 审计补上源码指纹检查。原文固定版本与原始数据保持不变,修正版不是新增在线模型结果。
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
下一篇已发布内容:Java LLM 实践(九):取消请求后,旧回答为什么还会覆盖新会话? →
当前学习位置
构建 / AI 应用开发
- ○ Java LLM 实践(五):工具超时了,为什么任务还在执行?
- ○ Java LLM 实践(八):流式回答断了,半句答案该不该进入历史?
- ○ Java LLM 实践(九):取消请求后,旧回答为什么还会覆盖新会话?
继续探索
继续探索
接下来,走哪条路?
- Java 8 调用大语言模型:从第一次请求到多轮对话 →
用三个真实运行的 Java Demo,理解模型请求、JSON 解析、读取超时与对话历史。
- Java LLM 实践(七):引用是真的,为什么答案仍然不能通过? →
22 个固定配置案例,拆开引用存在、版本范围、字段支持与完整性,验证 Java 回答验收边界。
- Java LLM 实践(二):HTTP 200 之后,怎样验收模型的 JSON? →
从一次真实的代码围栏响应和三次超时出发,用 Java 8 实现严格结构校验、受限格式适配与可追溯的失败处理。
依据文章关联与同主题已发布内容整理,不使用随机推荐。