

學習 / 實作
Java LLM 實踐(七):引用是真的,為什麼答案仍然不能通過?
RAG / 檢索 · 工程案例
22 個固定配置案例,拆開引用存在、版本範圍、欄位支持與完整性,驗證 Java 回答驗收邊界。
這篇之後,已經有了哪些結果?
保留本文發表時的結論與下一步構想;以下是已發布的後續內容,不代表所有侷限皆已解決。
繼續探索
繼續探索
瀏覽統計暫不可用
本文目錄 7
上一輪的檢索實驗留下一個漏洞:引用的確出現在給模型的資料中,就說明答案有依據嗎?
看一個具體例子。資料寫著 read_timeout_ms=5000,回答卻說超時是 2000,並把那句原文附在後面。文檔存在、引文真實、格式正確,答案依然錯了。生產環境與開發環境混用、舊版配置被當成新版,也會留下看起來很完整的引用。
這篇把問題縮小到一個能嚴格驗收的 Java 配置問答契約。程式碼接收候選聲明,返回經過核對的欄位映射;22 個預先固定的案例里,僅檢查引用存在會放過 10 個違規案例。它是生成回答之後的一道應用邊界,不是通用自然語言事實核查器。
1. 把“有依據”拆成可以核對的條件
假設應用要查詢 payments 服務、prod 環境、v2 修訂的兩個欄位:讀取超時和是否重試。教學註冊表包含四份原創合成配置:
| 文檔 | 服務 / 環境 / 修訂 | read_timeout_ms | retry_enabled |
|---|---|---|---|
| prod-v2 | payments / prod / v2 | 5000 | false |
| prod-v1 | payments / prod / v1 | 2000 | true |
| dev-v2 | payments / dev / v2 | 12000 | true |
| billing-v2 | billing / prod / v2 | 5000 | false |
這些不是任何真實服務的配置。當前修訂由受信任的請求指定,不能讓候選回答自己選擇“哪一版算當前”。預設提供前三份資料;另一個測試專門提供 billing 文檔,驗證數值相同也不能跨服務借用證據。
一次通過需要同時滿足:文檔確實提供過、引文確實存在、服務和環境匹配、修訂匹配、欄位在請求範圍內、值一致、引文支持當前欄位,且沒有遺漏或重復聲明。
2. 不接收一段自由回答再猜它有沒有問題
本例的輸入只有 claims,每條聲明必須包含四個字串。下面是完整的正例:
{
  "claims": [
    {
      "field": "read_timeout_ms",
      "value": "5000",
      "doc": "prod-v2",
      "quote": "read_timeout_ms=5000"
    },
    {
      "field": "retry_enabled",
      "value": "false",
      "doc": "prod-v2",
      "quote": "retry_enabled=false"
    }
  ]
}
沒有獨立的 answer 欄位。否則可能出現“聲明部分通過,自由回答里又加了一句相反結論”的繞過。成功後 UI 只根據 accepted 欄位映射生成展示文本,不繼續透傳原始回答。
解析層使用已有 Gson 的 JsonReader,關閉寬松模式,並檢查重復屬性、未知屬性、非字串值、尾隨 JSON。總輸入上限為 8192 個 Java UTF-16 字符單元,單欄位上限 2048,最多八條聲明。這些是本例的輸入邊界,不是模型 Token 上限。
特別注意:JSON 對象中的重復鍵不能簡單依靠普通 Map 反序列化後再檢查,因為覆蓋發生後已經看不到重復項。本例在讀取屬性時就拒絕它。
3. 真實引用仍然會失敗的三種方式
第一種是值不一致。保留上面的引文,只把 value 改成 2000,結果是 VALUE_MISMATCH。原文真實性不能替代聲明正確性。
第二種是範圍不一致。引用 dev-v2 的 12000,即使值和引文完全相同,也會因為請求查的是 prod 而返回 SCOPE_MISMATCH。舊版 prod-v1 則返回 STALE_REVISION。
第三種是引文與欄位無關。將第一條聲明的引文改為同一資料中的 retry_enabled=false,引用檢查仍然通過,但欄位驗收返回 QUOTE_NOT_SUPPORTING。
核心程式碼的順序如下,完整實現見固定版本倉庫:
if (!request.revision.equals(s.revision))
    return reject("STALE_REVISION", true);

String value = s.facts.get(field);
if (value == null || !value.equals(c.get("value")))
    return reject("VALUE_MISMATCH", true);

if (!(field + "=" + value).equals(c.get("quote")))
    return reject("QUOTE_NOT_SUPPORTING", true);

accepted.put(field, value);
這裡故意使用嚴格的規範表示 field=value。5s 與 5000 不自動視為相同,也不接受同義改寫。對於閉合配置表,這是可解釋的取舍;對於普通文章問答,它過於嚴格,需要另一套有標注的語義支持評估。
4. 22 個案例實際留下了什麼
案例和預期狀態在運行前隨程式碼凍結,分為 3 個正例和 19 個負例。正例覆蓋完整回答、欄位順序交換,以及請求只需要一個欄位的情況。負例覆蓋範圍、版本、值、證據、欄位集合和輸入語法。
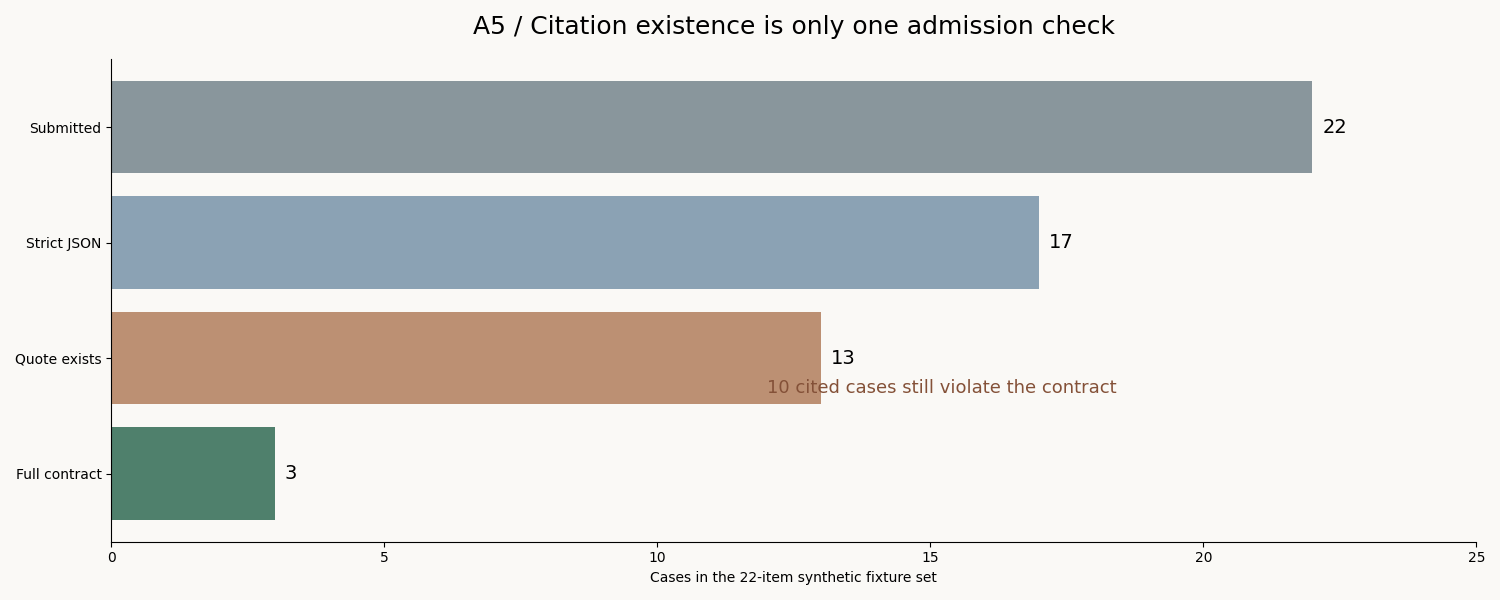
| 檢查層 | 通過數量 | 仍然不能排除什麼 |
|---|---|---|
| 嚴格 JSON | 17 / 22 | 合法格式里的錯誤聲明 |
| 引用存在於已提供資料 | 13 / 22 | 舊修訂、跨環境、無關引文、遺漏等 |
| 完整欄位契約 | 3 / 22 | 註冊表本身是否真實、可信、及時 |
完整契約的 22 個實際狀態與凍結標籤相符。這個分母是定向設計的測試集,不能寫成“RAG 準確率 100%”。也沒有進行模型生成、更大語料檢索或有無 RAG 的在線對照。
另一個邊界案例把資料中的一段指令式文字當成引文。它確實存在,所以引用基線接受;它不等於所需欄位的規範事實,因此契約拒絕。程序始終把資料當資料,沒有執行其中的指令。這只驗證當前閉合結構的行為,不構成完整的提示注入防護證明。
5. 失敗時不返回半份可用結果
如果第一個欄位正確,第二個欄位不正確,應該留下第一個欄位嗎?本例選擇整次拒絕,accepted 為空。否則呼叫者可能把局部結果誤當成完整答復。
成功結果則複製為排序後的不可修改 Map。重復聲明返回 DUPLICATE_CLAIM,額外欄位返回 UNREQUESTED_FIELD,遺漏返回 INCOMPLETE。這些狀態幫助區分修復方向,但不會觸發自動重試、自動修訂請求版本或放寬校驗。
這一策略適合“必須完整答復指定配置”的介面。產品如果需要部分回答,應明確設計欄位級狀態和缺失提示,而不是讓失敗結果意外泄漏出半份成功資料。
6. 如何復現和自己改出一個反例
需要 Java 8、Maven 和 Python 3;沿用 Gson 2.10.1。本次實際環境為 Java 8u171。進入 hohoo-ai-lab 倉庫:
python demos/07-grounded-claims/run.py --out demos/07-grounded-claims/evidence/MY-RUN
python demos/07-grounded-claims/audit.py demos/07-grounded-claims/evidence/MY-RUN
Maven 不在 PATH 時,給 run.py 追加 --maven 與可執行檔案路徑。輸出必須使用新目錄,不能覆蓋歸檔結果。manifest.json 記錄凍結原始碼和輸入,results.json 保存逐例狀態,獨立 Python 審計重算引用基線並核對標籤、輸出與哈希。
建議練習:先複製 fixtures,再只改正確案例的引文為另一個真實欄位。運行前寫下預測:引用基線應通過,完整契約應拒絕。然後把引用改回去、只改聲明值,比較失敗類型為何不同。不要為了讓測試通過而改原始歸檔標籤。
7. 下一道邊界在哪里
這裡最重要的假設是:請求範圍和事實註冊表由應用控制。若註冊表寫錯了,本程序可以非常穩定地接受錯誤事實;若請求者無權讀取某個環境,這個校驗器也沒有替代身份授權。
下一步仍沿用已有 RAG 實驗:對普通句子建立“支持、矛盾、證據不足”的標注,再接入固定模型的成組對照。此次先解決結構化配置場景中可確定的部分,不把字串一致性稱為自然語言理解。
寫給未來的自己合上文章前,留下一點自己的理解。
你的私人學習便箋,只存在目前瀏覽器,不會上傳或公開。清理瀏覽器資料會遺失,請匯出留存。三種語言共用這篇文章的便箋。
目前學習位置
檢索 / RAG · 檢索增強生成
- ○ Java LLM 實踐(六):先驗收檢索證據,再談RAG回答
- ○ Java LLM 實踐(七):引用是真的,為什麼答案仍然不能通過?
繼續探索
繼續探索
接下來,走哪條路?
- Java LLM 實踐(六):先驗收檢索證據,再談RAG回答 →
10篇原創合成資料、14個固定問題,手寫BM25與引用邊界;保留詞匯失配和無答案題的誤命中。
- Java LLM 實踐(五):工具超時了,為什麼任務還在執行? →
用白名單、嚴格參數、零佇列與調用預算構建只讀工具致動器,並重現取消不等於終止的邊界。
依據文章關聯與同主題已發布內容整理,不使用隨機推薦。