

學習 / 實作
Java LLM 實踐(八):流式回答斷了,半句答案該不該進入歷史?
AI 應用 / 構建 · 工程案例
22 個回環 HTTP 案例,驗證 UTF-8、SSE 分幀、取消與異常結束,把逐步預覽和完整歷史提交分開。
這篇之後,已經有了哪些結果?
保留本文發表時的結論與下一步構想;以下是已發布的後續內容,不代表所有侷限皆已解決。
繼續探索
繼續探索
瀏覽統計暫不可用
本文目錄 8
HTTP 200 已經返回,屏幕也顯示了半句話。此時網絡斷開,這輪對話算成功嗎?如果把半句話加入 messages,下一輪模型會把它當成已經說完的回答。一個顯示層的小問題,就這樣變成了上下文問題。
這一篇把前面整段 JSON 響應改成 SSE 文本流,但只做一件事:預覽可以逐步更新,歷史必須等完整結束後再提交。 22 個凍結案例通過本機真實 HTTP 連接執行:6 個完整結束,16 個異常或取消案例均保留原歷史。這是協議與會話邊界實驗,沒有呼叫 Agnes,也沒有驗證任何在線模型的流式兼容性。
先拆開四種邊界
流式讀取容易混淆四件事:網絡一次讀到了多少位元組、解碼出了多少字元、一個 SSE 事件何時結束、一輪回答是否已經完成。它們不是同一條邊界。
| 層次 | 判斷什麼 | 常見錯誤 |
|---|---|---|
| 位元組讀取 | InputStream.read 返回了一段資料 |
把一次讀取當成一個完整 Token 或 JSON |
| UTF-8 解碼 | 跨讀取保留未完成的多位元組字元 | 每段單獨 new String(bytes, UTF_8) |
| SSE 分幀 | 空行分隔事件,多行 data: 合並 |
每讀到一行就交給 JSON 解析器 |
| 回答驗收 | 結束原因和應用終止標記滿足約定 | 把 HTTP 200、EOF 或可見文字當作成功 |
SSE 的換行、注釋與多行 data 規則來自 WHATWG 規范。choices、finish_reason 和 [DONE] 屬於本例采用的應用協議,不是 SSE 標準規定的欄位。
為什麼中文會在流里損壞
假設“你”的 UTF-8 位元組跨過兩次讀取。第一段缺少剩餘位元組,此時單獨解碼可能產生替換字元;第二段再解碼,也無法補回已經丟失的狀態。不能靠增大緩衝區保證每次都恰好落在字元邊界。
示例用一個持續存在的 InputStreamReader 承接位元組流,拒絕非法 UTF-8:
Reader reader = new InputStreamReader(
    input,
    StandardCharsets.UTF_8.newDecoder()
        .onMalformedInput(CodingErrorAction.REPORT)
        .onUnmappableCharacter(CodingErrorAction.REPORT)
);
為了穩定復現,客戶端包裝器把每次批量讀取上限限制為 1 或 7 位元組。這控制的是讀取粒度,不聲稱控制了 TCP 分包。服務端和操作系統仍可合並傳輸。
在同一份 one-byte.sse 上,逐位元組獨立解碼的對照產生 13 個替換字元;持續解碼器最終得到 你好,Java 🌱。這是固定輸入的結果,不是中文網絡故障發生率。1 位元組上限路徑記錄 253 次讀取,7 位元組路徑為 37 次,也不據此推斷吞吐性能。
解析器什麼時候才能交出一個事件
下列內容雖然分成兩行 data:,仍然只有一個事件。解析時需要用換行連接兩行值,遇到後面的空行才交給 JSON 層。
data: {
data: "choices":[{"index":0,"delta":{"content":"你好"},"finish_reason":null}]}
StreamReader 同時處理 LF、CRLF、單獨 CR、開頭的 BOM 和冒號注釋。這裡不會使用 id 自動恢復請求,也不會讓 retry 啟動隱式重連。重連涉及已經顯示的內容如何去重、已經執行的副作用能否重複,不能作為解析器的小補丁偷偷加進去。
JSON 層拒絕重複欄位、尾隨內容與過深嵌套。文本層只接受單個 choices[0]、索引 0、role/content 增量以及可選用量幀。工具呼叫增量會被拒絕:工具參數需要另一套拼接和驗收狀態機,不能拿“文本能顯示”替代“參數可以執行”。
預覽與提交分開
本例的成功條件是:收到非空文本,收到 finish_reason: "stop",然後收到由空行正常結束的 [DONE] 事件。只有解析器按這個條件返回,呼叫方才向歷史追加當前用戶問題和完整回答。
// history initially contains the previous user/assistant pair.
String answer = reader.read(input, this::updatePreview);
// Reached only after successful protocol completion.
history.add("U:" + question);
history.add("A:" + answer);
示例片段表達呼叫順序;倉庫里的 Suite 用固定問題和列表實際驗證這條邊界。異常路徑關閉連接,保留預覽供界面解釋,但不把預覽轉成正式回答。重試時重新提交問題,不能先在歷史里留下重複的用戶訊息。
這是一輪請求內的提交邊界,不是資料庫事務,也沒有並發會話鎖。真實服務還要防止舊請求的完成回調寫進已經切換的會話。
22 個案例實際發生了什麼
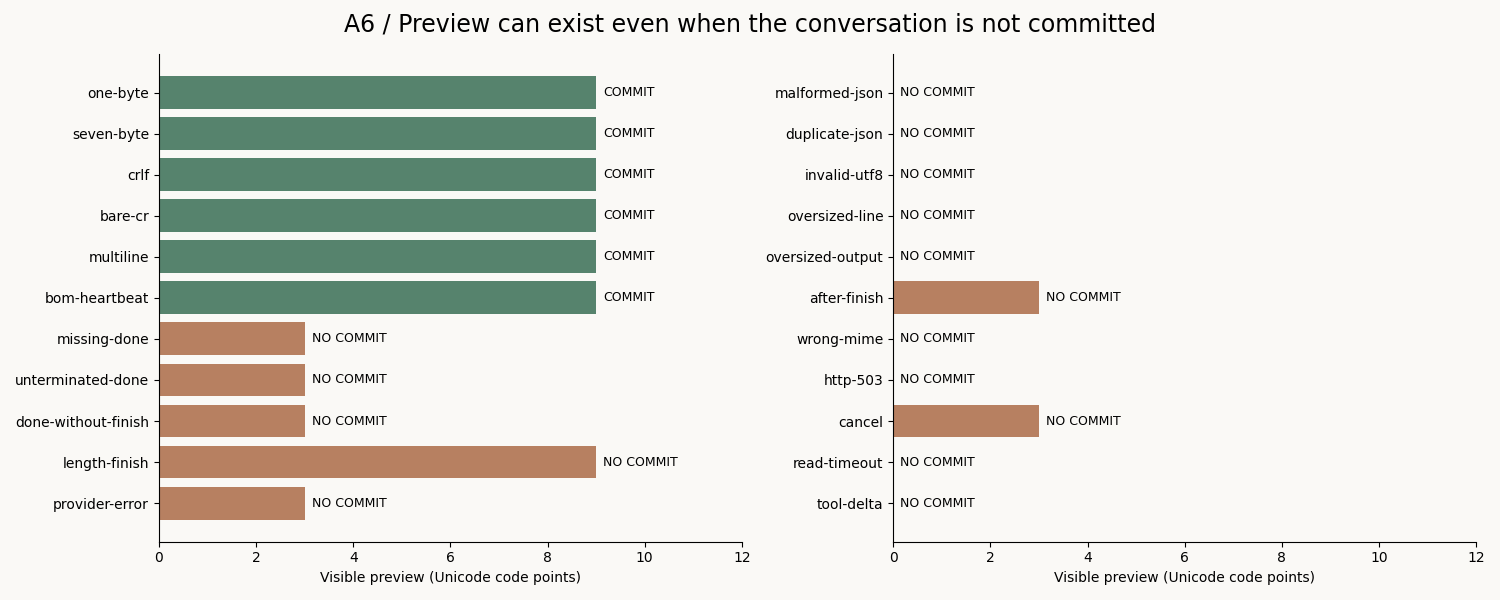
| 案例組 | 數量 | 觀察到的結果 |
|---|---|---|
| 1/7 位元組讀取、三種換行、多行資料、BOM/心跳 | 6 | 完整回答相同,歷史由 2 條變為 4 條 |
| 缺少 DONE、DONE 未以空行結束 | 2 | INCOMPLETE_STREAM,已有“你好,”也不提交 |
| 沒有 stop 就 DONE、stop 後繼續正文、工具增量 | 3 | PROTOCOL |
length 結束、服務端錯誤幀 |
2 | 分別為 INCOMPLETE_FINISH、PROVIDER_ERROR |
| 非法/重複 JSON、非法 UTF-8 | 3 | 解析失敗,歷史不變 |
| 行超限、輸出超限 | 2 | LIMIT |
| 錯誤 MIME、HTTP 503 | 2 | 進入正文協議前拒絕 |
| 用戶取消、讀取超時 | 2 | CANCELLED、READ_TIMEOUT |
值得注意的是 length-finish:屏幕已經出現完整的測試字串,仍然被拒絕。驗收遵守結束原因,不能根據“看上去像一句完整話”猜測是否截斷。
取消案例在預覽達到 3 個 Java 字元單元時主動拋出取消信號;超時案例讓服務端先發送響應頭、再等待 400ms,而客戶端讀超時為 100ms。兩者均沒有提交歷史。所有案例都保存原始 SSE、狀態和歷史長度,獨立審計檢查了固定標簽、檔案哈希和提交條件。
資源上限也是協議的一部分
示例限制單行 8,192、單事件 8,192、總輸入 65,536、輸出 4,096 個 Java UTF-16 字元單元;最多 256 個資料事件,JSON 深度不超過 16。圖中預覽長度使用 Unicode 碼點計數,與 Java 的長度單位不同,emoji 尤其要注意。
字元處理期限為 2 秒,但檢查只發生在讀取字元之後。因此它不是能中斷任意阻塞操作的嚴格總截止時間;連接與 socket 讀取超時仍然分別設置。限長案例覆蓋了行和輸出上限,不能把這 22 個案例說成所有資源邊界的窮盡測試。
如何復現和繼續改
準備 Java 8、Maven、Python 3。Java 依賴只有現有 Gson 2.10.1;審計用 Python 標準庫,圖表才需要 Matplotlib。
python demos/08-streaming-boundary/run.py --out demos/08-streaming-boundary/evidence/MY-RUN
python demos/08-streaming-boundary/audit.py demos/08-streaming-boundary/evidence/MY-RUN
Maven 不在路徑中時用 --maven 指定可執行檔案;依賴已快取時可用 --offline。輸出目錄必須是新的。歸檔采用 20261003-r2:首次嘗試停在未固定的插件解析階段,沒有開始 HTTP 案例;改成倉庫已有的固定版本插件後才完成實驗。
建議先做兩個小改動來理解邊界:把 stop 改成 length,觀察“能顯示但不提交”;刪掉 DONE 後最後一個空行,觀察“終止文字出現了但事件未完整結束”。最後再接真實供應商協議,分別驗證錯誤事件、用量幀和工具增量,不能直接把本地通過當成線上兼容。
這一輪得到的可用原則是:屏幕上的臨時輸出和下一輪請求的正式歷史,應當有不同的生命周期。 後續需要補的是並發取消、請求身份與冪等重試,而不是給每個異常自動重發一次。
修復進展 · 2026-10-07
2026-10-07 修正:Demo08–10 增加 JSON 詞法校驗,三個範例各通過 53 項離線回歸;執行腳本改用 Maven 參數列表,支援含空格目錄。Demo10 稽核補上原始碼指紋檢查。原文固定版本與原始資料保持不變,修正版不是新增線上模型結果。
寫給未來的自己合上文章前,留下一點自己的理解。
你的私人學習便箋,只存在目前瀏覽器,不會上傳或公開。清理瀏覽器資料會遺失,請匯出留存。三種語言共用這篇文章的便箋。
下一篇已發布內容:Java LLM 實踐(九):取消請求後,舊回答為什麼還會覆蓋新會話? →
目前學習位置
構建 / AI 應用開發
- ○ Java LLM 實踐(五):工具超時了,為什麼任務還在執行?
- ○ Java LLM 實踐(八):流式回答斷了,半句答案該不該進入歷史?
- ○ Java LLM 實踐(九):取消請求後,舊回答為什麼還會覆蓋新會話?
繼續探索
繼續探索
接下來,走哪條路?
- 用 Java 8 呼叫大型語言模型:從第一次請求到多輪對話 →
透過三個實際執行的 Java 範例,理解模型請求、JSON 解析、讀取逾時與對話歷史。
- Java LLM 實踐(七):引用是真的,為什麼答案仍然不能通過? →
22 個固定配置案例,拆開引用存在、版本範圍、欄位支持與完整性,驗證 Java 回答驗收邊界。
- Java LLM 實踐(二):HTTP 200 之后,怎樣驗收模型的 JSON? →
從一次真實的代碼圍欄響應和三次超時出發,用 Java 8 實現嚴格結構校驗、受限格式適配與可追溯的失敗處理。
依據文章關聯與同主題已發布內容整理,不使用隨機推薦。