

学习 / 实践
LLM 机制实验(五):改了历史,能否只重算变化的后缀?
llm / 理解 · 机制拆解
27 个固定条件、81 个原始数组,验证最长相同前缀裁剪、位置同步、滑窗回退与作用域隔离。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 7
上一篇给前缀缓存加上身份校验:Token、权重、窗口或作用域不匹配,就重新计算。正确性有了,但策略很保守。用户只改了第八个 Token,前七个 Token 的计算真的也要扔掉吗?
本轮在同一个未训练的 NumPy Decoder 上实现“最长相同前缀”复用。三个固定种子、九种条件,共 27 例。正确路径与完整重算的最大绝对误差约为 3.89e-16;故意保留旧位置编号的路径,在九个局部复用案例中产生明显误差。
这里比较的是中间状态数值与投影行数,没有测量在线模型、GPU 时延、生成质量或实际服务吞吐。
先看一次历史编辑
把 Token ID 简写成数字。缓存中已有:
old: 1 2 3 4 5 6 7 8
new: 1 2 3 4 20 6 7 8 9 10 11 12
     └─ 相同 ─┘ └────── 必须重算 ──────┘
cut = 4
虽然新序列第六到第八个 Token 的 ID 又与旧序列相同,它们的缓存也不能直接拿来用:中间已经改变的 Token 会影响后续层的上下文。可复用的是从开头连续相同的一段,而不是把所有相同 ID 的位置拼起来。
在本例的因果注意力中,相同前缀的状态不依赖未来 Token。因此,在计算配置和位置都相同的前提下,可以保留每一层前 cut 行 K/V,再从绝对位置 cut 继续计算。KV Cache 的一般用途与配置差异可参见 Transformers 缓存文档;本文下面的实现与数字来自本地教学模型。
哪些东西必须一起裁剪
仓库里的缓存保存三类内容:各层 K、各层 V、每行的绝对位置。此外还有下一段输入的起始位置 next_position。
cache = {
    'next_position': cut,
    'layers': [
        (k[:cut].copy(), v[:cut].copy(), positions[:cut].copy())
        for k, v, positions in stored['layers']
    ],
}
out, _ = model.chunk(tokens[cut:], cache=cache)
只裁剪 K/V、不修改 next_position,会把新后缀继续放到旧长度 8 后面。此时前四个缓存位置是 0、1、2、3,新 Token 却从位置 8 开始编码,中间凭空跳过四个位置。张量维度仍能对上,程序可能不会报错,数值却已经偏离目标计算。
这也是本轮的负对照:相同的裁剪、相同的后缀,只故意保留旧 next_position。不要把这种位置错位与浮点舍入误差混为一谈。
查询流程与缓存所有权
Store 最多保留两条预填充结果。本轮先存普通前缀 1..8,再存分支 1,2,3,4,5,20,21,22。查询按以下顺序执行:
- 验证非空整数 Token ID;浮点数
1.0不能因为转成整数后相同就命中。 - 比较应用作用域和计算签名。签名包含模型权重、实现、窗口和位置编码约定。
- 在合格条目里找最长连续相同前缀;并列时使用最近插入条目。
- 复制需要保留的 K/V 和位置,再计算剩余后缀。
复制让这次查询不能修改另一条分支持有的 NumPy 数组。它只是本地所有权约束,不等于生产缓存的分页、引用计数或跨进程并发控制。scope 也是调用方提供的字符串,不是用户认证系统。
还有一个容易忽略的边界:查询比缓存更短,或者完全等于缓存。这里没有额外保存各 Token 的最终输出,所以令 cut <= len(query)-1,至少重算最后一个 Token,避免空后缀却拿不到输出。若生产实现保存了额外输出,可以设计另一条路径,不能直接从这份示例推断“整段命中无需任何计算”。
27 例得到的计算量与误差
模型保持上一轮配置:两层、单头、维度 16、词表 32、float64、绝对正弦位置编码和 tanh 残差;没有训练、FFN、LayerNorm 或自然语言 tokenizer。种子为 7、11、23。
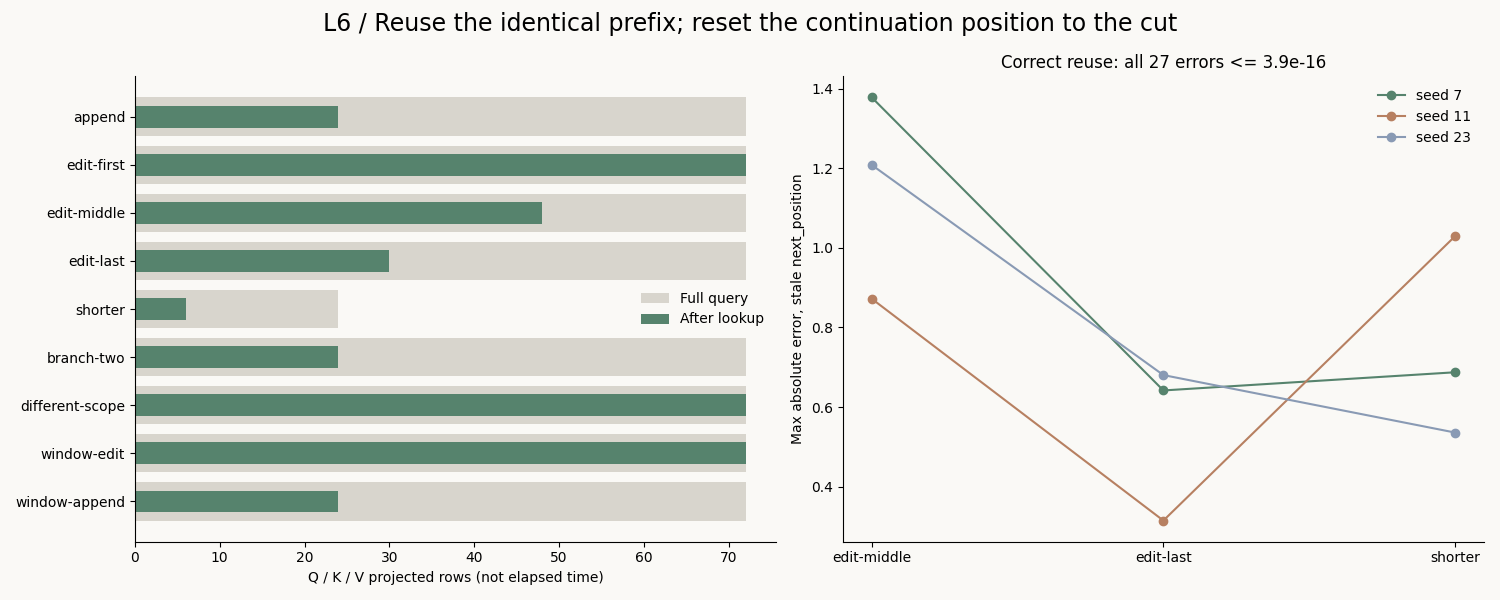
| 条件 | 查询长度 | 复用行数 cut | 本次投影行数 | 完整重算投影行数 |
|---|---|---|---|---|
| 原前缀后追加 | 12 | 8 | 24 | 72 |
| 修改首 Token | 12 | 0 | 72 | 72 |
| 修改第五个 Token | 12 | 4 | 48 | 72 |
| 修改第八个 Token | 12 | 7 | 30 | 72 |
| 缩短成前四个 Token | 4 | 3 | 6 | 24 |
| 从第二条分支追加 | 12 | 8 | 24 | 72 |
| 更换作用域 | 12 | 0 | 72 | 72 |
| 滑窗缓存中修改第五个 Token | 12 | 0 | 72 | 72 |
| 滑窗缓存后正常追加 | 12 | 8 | 24 | 72 |
投影计数为 层数 × Q/K/V 三次投影 × 新计算 Token 数,即本例的 6 × (queryLength-cut)。这是继续计算阶段的计数,不包括原先预填充、全权重哈希、查找、复制和内存管理成本,所以不能把 72 降到 24 写成“推理加速三倍”。
独立审计重算了 81 个归档数组的 54 项误差,并检查切点和投影计数。全部正确路径误差低于冻结阈值 1e-12。九个局部复用负对照明显超出阈值:种子 7 的中段修改误差为 1.37749785,末尾修改为 0.64189345。这证明的是本矩阵能暴露位置错误,不是未训练模型的语言能力。
为什么滑窗部分命中必须回退
全注意力缓存还保留前八行时,可以取前四行。窗口为 4 的缓存则只剩最后四行,即位置 4、5、6、7;想复用位置 0、1、2、3 时,数据已经被淘汰。
不能对“剩余数组的前四行”执行切片后,把它们重新命名为“历史的前四行”。本实现对滑窗采用保守规则:只有整条已缓存前缀匹配、并且查询还包含新后缀时,才复用现存窗口;部分命中直接重算。
这并不意味着滑窗永远不能复用较短前缀。若保存检查点、分页历史或可回滚的其他状态,可以设计更细的策略。本轮没有这些存储结构,因此不假装存在可用缓存。
如何复现并验证自己理解了
在 hohoo-ai-lab 仓库根目录执行,环境需要 Python 3 与 NumPy。归档环境为 Python 3.12.14、NumPy 2.2.6;没有模型密钥。
python -m unittest discover -s experiments/07-prefix-reuse -p "test_*.py"
python experiments/07-prefix-reuse/run.py --out experiments/07-prefix-reuse/evidence/MY-RUN
python experiments/07-prefix-reuse/audit.py experiments/07-prefix-reuse/evidence/MY-RUN
七项测试覆盖中段编辑、单 Token 查询、分支不变性、作用域/权重变化、滑窗回退、容量和非法 ID。输出目录必须新建,审计检查源文件与原始数组哈希;不要覆盖旧结果来隐藏失败。
可以先把编辑位置从第五个 Token 改到第二个,预测切点应变成 1,再运行新条件。接着问自己:即使第六个 Token 的 ID 没变,它上层的表示为什么也需要重算?如果只能回答“缓存失效”,还没有抓住因果前缀的依赖关系。
这一轮留下的工程判断
缓存复用的单位是身份与计算条件一致的连续前缀。正确切片只是其中一半;下一段的位置、滑窗里还剩什么、条目属于哪个作用域,同样决定能否复用。
下一步适合验证分块存储与淘汰后的复用率,同时把查找、复制、预填充成本纳入测量。当前计数不足以回答生产系统是否更快,也不能直接移植到 RoPE、量化 KV 或多请求调度器而不重新验证。
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
下一篇已发布内容:LLM 机制实验(六):缓存加大了,为什么还是一次都没命中? →
当前学习位置
理解 / LLM
- ○ LLM 机制实验(四):前缀改了,旧 KV Cache 还能继续用吗?
- ○ LLM 机制实验(五):改了历史,能否只重算变化的后缀?
- ○ LLM 机制实验(六):缓存加大了,为什么还是一次都没命中?
继续探索
继续探索
接下来,走哪条路?
- LLM 机制实验(四):前缀改了,旧 KV Cache 还能继续用吗? →
三种子、六条件,比较错误复用与带键校验的前缀缓存;数值相同也不代表允许跨作用域共享。
- LLM机制实验(三):缓存只留四格,为什么不等于重算四个Token? →
用双层滑动注意力区分绝对位置、缓存槽位和历史表示,展示两种形状正确却计算错误的实现。
依据文章关联与同主题已发布内容整理,不使用随机推荐。