

学习 / 实践
LLM 机制实验(六):缓存加大了,为什么还是一次都没命中?
llm / 理解 · 机制拆解
27 条冷启动轨迹、324 次请求与 648 个数组,按字节限制前缀检查点,观察工作集、隔离与 LRU 淘汰的实际收益。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 8
上一轮已经能找到最长相同前缀,只重算变化后的 Token。但缓存不能无限保留。当预算只能容纳少量前缀时,重复请求是否还会省计算?
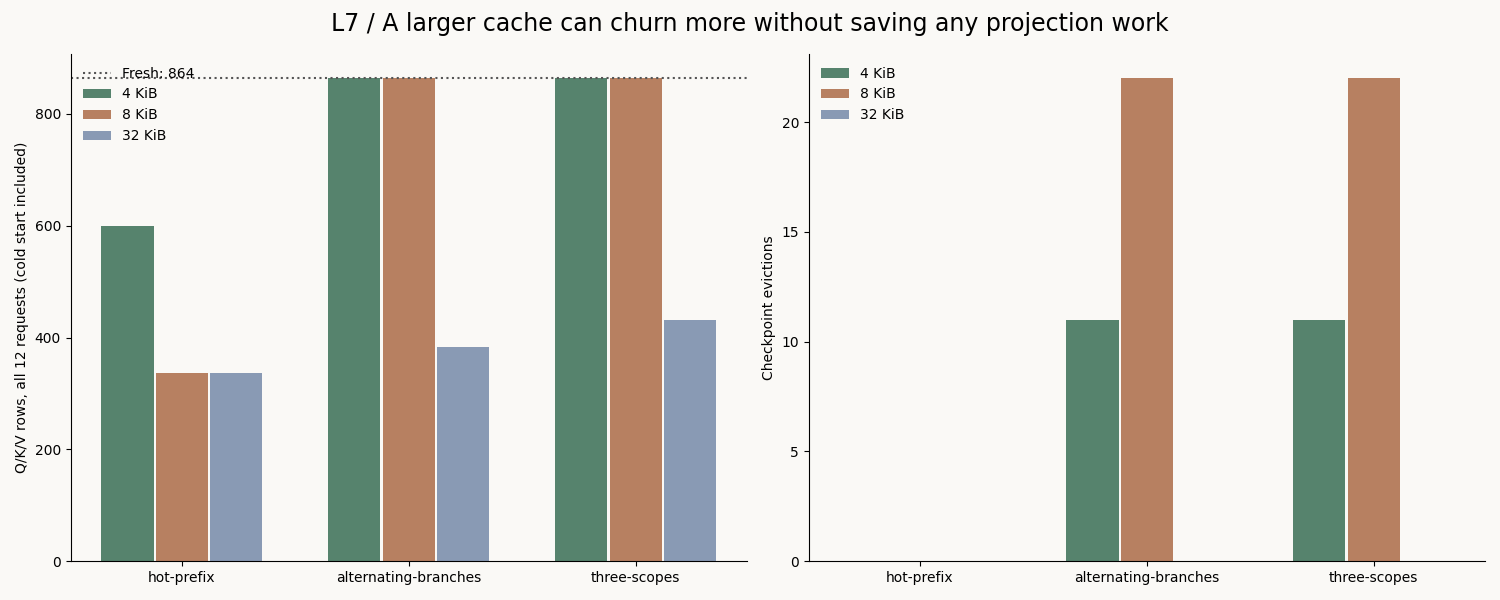
这次从冷缓存开始,把 12 次请求看成一个整体,计入每次首次填充、未命中后的重算与后续命中。结果中最值得注意的一组不是最好的数字:两个前缀交替访问时,预算从 4 KiB 加到 8 KiB,仍没有节省一次投影计算,淘汰次数却从 11 增加到 22。
我们缓存的是什么
沿用前面的未训练双层 NumPy 解码器:隐藏维度 16,float64,词表 32,固定权重种子 7、11、23。它用来检查计算等价性,不生成自然语言,也不代表 Agnes 的推理引擎。
在第 4、8 个 Token 后可以保存完整前缀检查点。一个检查点包含每层的 K、V、绝对位置数组,以及继续计算的位置。不同检查点持有自己的数组副本,没有共享底层页。
每个 Token 在持久数组中的字节数为:
2 层 × (K: 16×8 + V: 16×8 + position: 8) = 528 字节
4 Token 检查点 = 2,112 字节
8 Token 检查点 = 4,224 字节
同一前缀的两个检查点合计 = 6,336 字节
预算使用数组真实的 nbytes 计算,不用“最多两条记录”代替内存约束。但这个数字不是进程内存:不包含 Python 对象、Token 键、模型权重、活跃请求的临时数组或 NumPy 内部工作区。
固定访问顺序,才能解释命中率
每条轨迹有 12 个请求,每个请求 12 个 Token。末尾 Token 会变化,前 8 个由轨迹决定:
| 轨迹 | 请求顺序 | 想验证的问题 |
|---|---|---|
| 单一热点 | 相同前 8 Token,同一作用域 | 缓存装得下时能否持续命中 |
| 两分支交替 | 两组不同前缀轮流出现 | 容量是否足够容纳工作集 |
| 三作用域轮转 | Token 相同,作用域依次为 A/B/C | 隔离后是否仍然装得下 |
预算分别为 4、8、32 KiB。3 个权重种子 × 3 个预算 × 3 条轨迹 × 12 次请求,共 324 次请求。
作用域使用合成字符串,是缓存键的一部分,不是用户认证。相同文本属于不同作用域时故意不复用,避免把“文本一样”误当成“可以共享”。
一次查询如何执行
- 验证 Token,计算模型与配置签名。
- 在同一作用域、相同签名的记录中找最长完整前缀。
- 将命中的检查点复制给当前请求,更新最近使用顺序。
- 从命中位置继续分段计算;到达新的检查点边界时尝试保存。
- 太大的单个检查点直接跳过;否则先淘汰最久未用的记录,再保存副本。
查找只复用严格短于当前请求的检查点,因此本轮总能返回至少一个新的状态。本次请求长度固定为 12,保存边界为 4 和 8。它不是按页共享的 PagedAttention 实现,也没有滑动窗口驱逐后的局部重建。
核心容量条件是:
cost = sum(array.nbytes for layer in checkpoint['layers'] for array in layer)
while resident_bytes + cost > budget:
    evict_least_recently_used()
save_owned_copy(checkpoint)
resident_bytes 限制的是长期保留检查点的数组总和。当前查询仍可能临时构造完整 K/V,这个限制不能直接拿去防止进程 OOM。
把首次填充也算进去
两层模型中,每个新 Token 需要 Q、K、V 三组投影,所以完整请求计为 2 × 3 × 12 = 72 个投影行。12 次完整重算是 864 行。以下计数在三个种子上相同;种子改变数值结果,不改变请求顺序和张量形状。
| 预算 | 轨迹 | 命中 / 12 | 全轨迹投影行 | 淘汰次数 | 显式检查点复制字节 |
|---|---|---|---|---|---|
| 4 KiB | 单一热点 | 11 | 600 | 0 | 25,344 |
| 4 KiB | 两分支交替 | 0 | 864 | 11 | 25,344 |
| 4 KiB | 三作用域轮转 | 0 | 864 | 11 | 25,344 |
| 8 KiB | 单一热点 | 11 | 336 | 0 | 52,800 |
| 8 KiB | 两分支交替 | 0 | 864 | 22 | 76,032 |
| 8 KiB | 三作用域轮转 | 0 | 864 | 22 | 76,032 |
| 32 KiB | 单一热点 | 11 | 336 | 0 | 52,800 |
| 32 KiB | 两分支交替 | 10 | 384 | 0 | 54,912 |
| 32 KiB | 三作用域轮转 | 9 | 432 | 0 | 57,024 |
例如 8 KiB 热点组:第一轮冷启动计算 72 行,后 11 轮各命中 8 个 Token,只计算剩余 4 个,即 72 + 11 × 24 = 336。
“复制字节”只统计代码中显式的检查点保存和命中取出,不包括解码器内部拼接、底层库搬运,也不等于实际内存带宽。
为什么更大的预算反而淘汰更多
8 KiB 能同时保存一组前缀的 4 Token 和 8 Token 检查点,共 6,336 字节。但两个分支需要 12,672 字节。
从 A 换到 B 时,先保存 B4,再保存 B8,A4/A8 会相继被淘汰。下一次回到 A,同样重新计算、保存和淘汰。整个过程中,缓存一直在工作,却没有一次命中。
4 KiB 只允许保存 4 Token 检查点,每次切换只淘汰一条;8 KiB 每次保存两条,因而发生两次淘汰。这里增加容量没有跨过工作集阈值,增加的检查点反而制造更多管理工作。
这不证明“缓存越大越差”,也不是所有 LRU 的普遍定理。它说明:在这个保存策略和访问轨迹下,记录数量、记录大小和复用距离需要一起考虑。 固定只保留最长检查点、按复用价值准入或共享前缀,都可能改变结果,必须另做对照。
结果等价性不能省略
每次缓存路径返回的后缀状态,都与同种子完整重算的对应位置比较。归档保存了 648 个数组,324 项最大绝对误差均低于 1e-12,实际最大值约 4.16e-16。
独立审计还会按请求顺序重建 LRU,逐项核对命中长度、淘汰记录、驻留字节和复制计数。7 个单元测试覆盖零预算、作用域隔离、权重变更、数组所有权、短查询、输入验证和每 Token 字节计算。
只报告命中率却不验证输出,很容易把错误复用当成优化。反过来,数值等价也不说明优化值得:8 KiB 交替组完全正确,但没有节省投影计算。
从这个实验能推到哪里
可以确定的是,这个小模型在冻结访问轨迹下,预算与工作集共同决定复用收益。不能推断的是生产模型的每秒 Token 数、GPU 显存占用、首 Token 延迟或成本下降。
Transformers 的 KV cache 文档可作为理解不同缓存策略的背景;本文所有计数来自本仓库的 NumPy 实验,不是对该库实现的基准测试。模型签名哈希、查找和 Python 管理也没有计时,所以不能把 864 / 336 写成实际加速倍数。
复现入口
python -m unittest discover -s experiments/08-cache-budget -p test_cache.py
python experiments/08-cache-budget/run.py --out experiments/08-cache-budget/evidence/my-run
python experiments/08-cache-budget/audit.py experiments/08-cache-budget/evidence/my-run
原始记录包含 results.json、arrays.npz、源码与文件哈希;audit.json 给出逐轨迹汇总。图表从这些结果生成,没有用拟造的曲线补趋势。
下一步有意义的优化是比较保存哪些检查点,并测量查找、复制、计算的端到端时间。当前先得到一个更可靠的判断方式:缓存是否有效,要看冷启动后的完整工作负载,而不是挑一次漂亮的命中。
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
下一篇已发布内容:LLM 机制实验(七):缓存省了计算,为什么实测反而更慢? →
当前学习位置
理解 / LLM
- ○ LLM 机制实验(五):改了历史,能否只重算变化的后缀?
- ○ LLM 机制实验(六):缓存加大了,为什么还是一次都没命中?
- ○ LLM 机制实验(七):缓存省了计算,为什么实测反而更慢?
继续探索
继续探索
接下来,走哪条路?
- LLM 机制实验(五):改了历史,能否只重算变化的后缀? →
27 个固定条件、81 个原始数组,验证最长相同前缀裁剪、位置同步、滑窗回退与作用域隔离。
- LLM 机制实验(四):前缀改了,旧 KV Cache 还能继续用吗? →
三种子、六条件,比较错误复用与带键校验的前缀缓存;数值相同也不代表允许跨作用域共享。
依据文章关联与同主题已发布内容整理,不使用随机推荐。