

学习 / 实践
LLM 机制实验(七):缓存省了计算,为什么实测反而更慢?
llm / 理解 · 机制拆解
4860次实测查询比较三种缓存准入策略,把字节预算、工作集、计算量与本地耗时放在一起验证。
这篇之后,已经有了哪些结果?
保留本文发表时的结论与下一步设想;以下是已发表的后续内容,不代表所有局限都已解决。
继续探索
继续探索
浏览统计暂不可用
本文目录 9
上一轮发现,8KiB 缓存遇到两个轮流访问的前缀,会发生零命中的反复淘汰。自然的下一步是少存一些检查点,把容量留给真正有用的前缀。
这次同时测量计算量和耗时。结果并不等于“缓存优化成功”:准入策略改善了某些访问轨迹,但在这个小型 NumPy 模型上,缓存查询仍然比直接重算慢。
先分清三个问题
| 要回答的问题 | 本系列怎样检查 | 能得出的结论 |
|---|---|---|
| 结果是否等价? | 相同输入下比较缓存续算与完整重算数组,误差阈值固定 | 本模型、精度和条件下数值一致,不能证明语义质量 |
| 计算是否减少? | 统计实际 Q/K/V 投影行数 | 少做了这些投影,不等于全部计算都等比例减少 |
| 用户是否等得更短? | 计时完整查询路径,保留无缓存基线和重复结果 | 本机、这组工作负载的时间;不能外推生产 LLM |
命中有效前缀 → 少投影一些 Token ─┐
签名、查找、复制、分段调用 ─────┼→ 查询总耗时(必须测量)
未命中时仍要重算 ─────────────┘
三 scope / 16KiB 是一个具体反例:longest 比 all 少算了一半投影行,但比 none 的查询中位数仍更慢。应当同时保留这两个比较对象,不能只选较慢的缓存基线制造“加速”。
小练习:864 行降到 432 行,能否说“快了 50%”?
不能。它只描述投影行数减少 50%。本轮相应耗时是 6.723ms,相比无缓存 1.697ms 并未加速。文件读取、哈希、复制等都在计时内,但还没有分段剖析,不能给其中任何一项分配“主要瓶颈”的结论。
本篇只改变保存哪些检查点
模型仍为两层、维度 16、词表 32 的未训练 Decoder,输入长度为 12 个 Token。前八个 Token 是可复用前缀,后四个是变化的后缀。我们比较三个策略:
| 策略 | 保存内容 | 下一次查询 |
|---|---|---|
none |
不保存 | 完整重算 12 个 Token,不做缓存签名和复制 |
all |
第 4、8 个 Token 处的完整前缀 | 查找最长可用前缀,再续算 |
longest |
只保存第 8 个 Token 处的完整前缀 | 使用相同查找、分段计算和 LRU 逻辑 |
all 和 longest 的差异是准入;后者即使不保存第 4 个检查点,也仍沿用相同分段计算路径。none 则是实际的无缓存基线,不为了形式一致而额外做它不需要的哈希或分段工作。
缓存条目分别拥有完整的 K、V、位置数组,没有共享前缀页。因此每 Token 的持久数组负载是 528 字节,四 Token 为 2,112 字节,八 Token 为 4,224 字节。这里的容量不是进程内存或 GPU 显存。
容量计算能预测什么,不能预测什么
三个隔离 scope 分别保留两个检查点,需要:
all:      3 × (2,112 + 4,224) = 19,008 bytes
longest:  3 × 4,224           = 12,672 bytes
16 KiB:                       16,384 bytes
因此 16KiB 能容纳三个最长检查点,却放不下三组全部检查点。scope 不同的条目即使 Token 相同也不共享,不能为了增加命中率破坏隔离。
但“全部检查点放不下”不一定表示零命中。12KiB 双分支的 all 组只发生一次淘汰:丢掉较短且之后不需要的检查点,仍保住两个长前缀,后续命中十次。容量算式提供上界,实际收益还要看访问顺序和淘汰后的状态。
测量边界:到底把什么算进了耗时
3 个种子 × 3 个预算(8、12、16KiB)× 3 条访问轨迹 × 3 种策略,共 81 个配置。每个配置先完整预热一次;随后执行五次测量,每轮随机交错配置顺序,每条轨迹都从新的模型对象和空缓存开始。
正式记录为 405 条轨迹、4,860 次请求;预热另有 972 次请求,不并入统计。每个“预算/轨迹/策略”的耗时汇总含 3 种子 × 5 重复,共 15 条轨迹。
start = time.perf_counter_ns()
states, info = store.query(scope, model, tokens)
elapsed_ns = time.perf_counter_ns() - start
# 参考计算放在计时区外,但仍逐请求验证数值一致性。
fresh, _ = model.full(tokens)计时覆盖签名校验、查找、数组复制、模型计算、准入和淘汰。不包括模型构造、参考重算、结果序列化和绘图。特别要注意:沿用的签名函数每次会读取模型源文件并哈希模型权重,这个文件读取也包含在查询耗时里。这不是已经优化过的生产缓存实现。
perf_counter_ns() 返回整数纳秒,适合记录时间差;纳秒单位不代表测量具备纳秒精度。Python 时间 API
16KiB 下:计算量减少,时间没有跟着下降
下表均为一条 12 请求轨迹,包含首次冷缓存请求。耗时为 15 条实测轨迹的中位数,括号是最小—最大范围。
| 访问轨迹 | 策略 | 命中 | Q/K/V 投影行 | 查询总耗时(ms) |
|---|---|---|---|---|
| 单一热点 | none | 0 | 864 | 1.646(1.607—3.260) |
| 单一热点 | all | 11 | 336 | 5.921(5.680—6.886) |
| 单一热点 | longest | 11 | 336 | 6.231(5.679—8.648) |
| 两个前缀交替 | none | 0 | 864 | 1.733(1.603—3.511) |
| 两个前缀交替 | all | 10 | 384 | 6.495(6.036—9.840) |
| 两个前缀交替 | longest | 10 | 384 | 6.282(5.846—7.138) |
| 三个隔离 scope | none | 0 | 864 | 1.697(1.612—2.126) |
| 三个隔离 scope | all | 0 | 864 | 10.263(9.255—15.599) |
| 三个隔离 scope | longest | 9 | 432 | 6.723(6.345—10.020) |
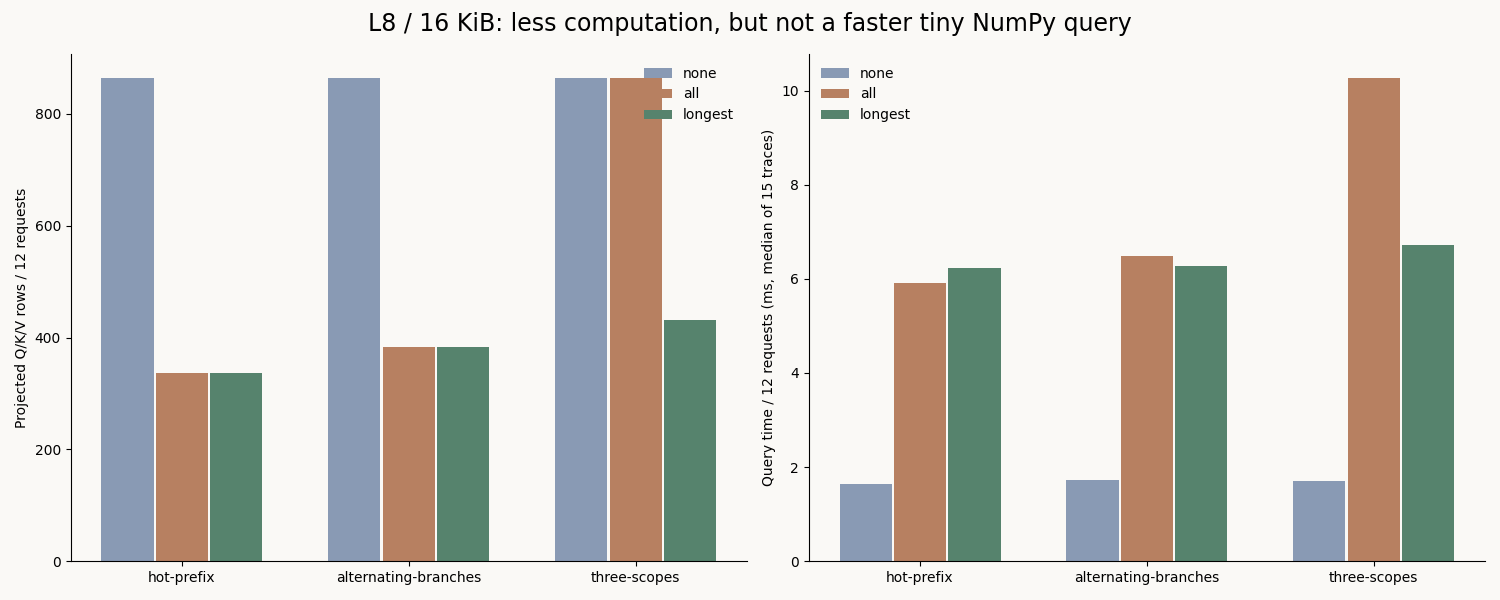
三 scope 组是准入变化最有解释力的对照:all 淘汰 20 次,longest 淘汰零次,投影行由 864 降到 432,查询时间中位数也由 10.263ms 降到 6.723ms。但无缓存基线只需 1.697ms,因此不能把相对另一种缓存策略的改善说成相对直接重算的加速。
热点组也没有“只存最长必然更快”:两种缓存策略都命中十一回,最长组的中位数反而略高,范围明显重叠。没有统计显著性分析,也没有对某次更快的运行挑选展示。
为什么会出现这种结果
这里的模型很小,矩阵运算成本低。缓存路径却必须维护签名、Python 容器、完整前缀副本和多个分段调用。无缓存路径直接完成一次完整计算,省去了这些管理步骤。
这是代码路径与结果共同支持的解释,不是各项开销的定量归因:本轮没有分别计时哈希、复制与矩阵计算,不能声称某一项占比多少。下一轮可以先剖析,再比较“模型加载时固定版本签名”和“每次重新计算签名”,同时保留模型变更失效测试。
不能直接删除签名来换速度。若权重或位置编码规则变化后仍沿用旧 K/V,较快地返回错误结果并不是优化。
两个应当保留的失败条件
8KiB 的双分支仍然零命中。 两个最长前缀需要 8,448 字节,超过 8,192 字节。longest 把淘汰次数从 22 降到 11,复制负载从 76,032 降到 50,688 字节,却没有节省投影计算。
12KiB 的三 scope 也仍然零命中。 三个最长前缀需要 12,672 字节,超过 12,288 字节。规则改得再简洁,也不能抹去工作集与容量的关系。
这些固定轨迹没有采样真实用户流量。表中的命中数量用于说明机制,不是线上缓存命中率预测。
从哪里开始,怎样复现
第一次读缓存可先看 容量与机制,再顺序检查 等价性 → 失效 → 最长前缀 → 字节预算。这些是已完成的离线数值实验。
另一条研究支线是 24 次 Agnes 3.0 真实调用。之后的 128 项相似干扰方案只有离线准备,没有新的真实模型结果,不能混入本篇数值实验的分母。
在新的目录中准备 Python 3.12 环境(下列为 PowerShell):
git clone https://github.com/VirtualSelect/hohoo-ai-lab.git hohoo-ai-lab-cache
cd hohoo-ai-lab-cache
git checkout 503f5271ef0d5baa12353d6eeda672dec5fc240e
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install numpy==2.2.6
cd experiments/09-cache-admission
..\..\.venv\Scripts\python.exe -m unittest discover -s . -p test_cache.py
..\..\.venv\Scripts\python.exe run.py --out evidence/my-run
..\..\.venv\Scripts\python.exe audit.py evidence/my-run预期产生逐请求记录与数组:检查误差、投影行和预算约束,再看时间分布。my-run 必须是新目录。时间无需与归档逐位相等;数值误差超过协议阈值才是正确性问题。缺少 NumPy 时先确认安装和执行使用同一解释器。
审计范围: 当前 audit.py 校验结果文件哈希并独立重算部分指标,但不会自动遍历 manifest.sources 核对源码;复现时必须同时固定上述提交。不能把“审计通过”读成源码、环境和生产性能均已证明。
附录:数值校验与归档结构
所有 4,860 次查询都与完整重算比较,最大绝对误差约 4.16 × 10⁻¹⁶。每个配置的首次测量还保存参考与复用两个数组,共 1,944 个数组,便于独立复算;后四次保存误差和时序,不重复归档数组。
六组边界测试覆盖非法策略、容量相差一字节、scope 隔离、模型身份变更、返回值与缓存内存隔离,以及只准入最长检查点。独立审计按 Token 与 scope 重放 LRU,不调用被测 Store 来判断结果。
需要项目既有的 Python/NumPy 环境;归档使用 Python 3.12.14、NumPy 2.2.6。manifest.json 保存冻结代码版本、环境、NumPy 配置、计时器分辨率与哈希;results.json 保留请求顺序、耗时、计算计数、复制字节和淘汰事件。
本轮不是专用基准机测量,没有 CPU 绑核、GPU 或真实模型推理;重复运行的时间会变化。它给出的可迁移结论是:同时报告正确性、容量、工作量和真实耗时,才能判断一个缓存优化究竟优化了什么。
修复进展 · 2026-10-07
2026-10-07 修正:审计现在逐项校验 manifest.sources,拒绝源码变化、缺失文件或越界路径。旧 4,860 次查询与耗时保持原样;本次源码一致性回归不提供新的缓存性能结论。
写给未来的自己合上文章前,留下一点自己的理解。
你的私人学习便签,只存在当前浏览器,不会上传或公开。清理浏览器数据会丢失,请导出留存。三种语言共用这篇文章的便签。
下一篇已发布内容:把答案放在上下文中间,模型就会漏掉吗?一次提前停止的对照试验 →
当前学习位置
理解 / LLM
- ○ LLM 机制实验(六):缓存加大了,为什么还是一次都没命中?
- ○ LLM 机制实验(七):缓存省了计算,为什么实测反而更慢?
- ○ 把答案放在上下文中间,模型就会漏掉吗?一次提前停止的对照试验
继续探索
继续探索
接下来,走哪条路?
- LLM 机制实验(六):缓存加大了,为什么还是一次都没命中? →
27 条冷启动轨迹、324 次请求与 648 个数组,按字节限制前缀检查点,观察工作集、隔离与 LRU 淘汰的实际收益。
- LLM 机制实验(四):前缀改了,旧 KV Cache 还能继续用吗? →
三种子、六条件,比较错误复用与带键校验的前缀缓存;数值相同也不代表允许跨作用域共享。
依据文章关联与同主题已发布内容整理,不使用随机推荐。