

學習 / 實作
LLM 機制實驗(六):快取加大了,為什麼還是一次都沒命中?
llm / 理解 · 機制拆解
27 條冷啟動軌跡、324 次請求與 648 個陣列,按位元組限制前綴檢查點,觀察工作集、隔離與 LRU 淘汰的實際收益。
這篇之後,已經有了哪些結果?
保留本文發表時的結論與下一步構想;以下是已發布的後續內容,不代表所有侷限皆已解決。
繼續探索
繼續探索
瀏覽統計暫不可用
本文目錄 8
上一輪已經能找到最長相同前綴,只重算變化後的 Token。但快取不能無限保留。當預算只能容納少量前綴時,重複請求是否還會省計算?
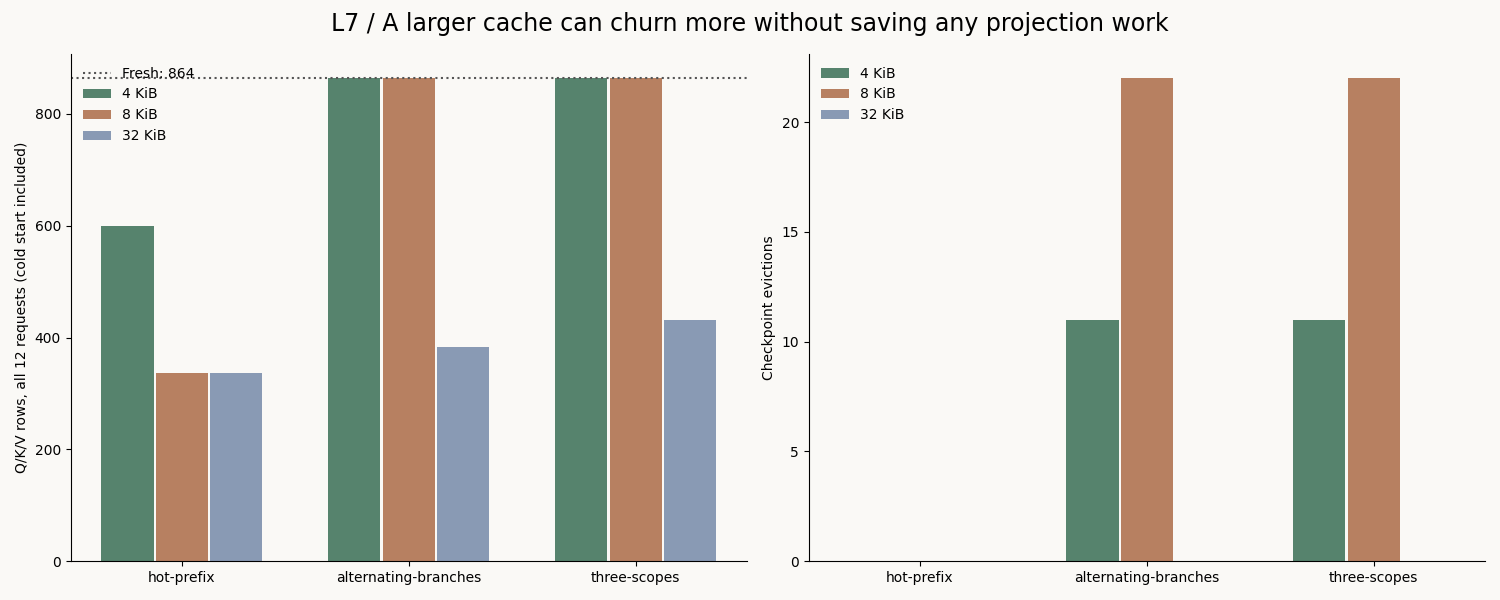
這次從冷快取開始,把 12 次請求看成一個整體,計入每次首次填充、未命中後的重算與後續命中。結果中最值得注意的一組不是最好的數字:兩個前綴交替訪問時,預算從 4 KiB 加到 8 KiB,仍沒有節省一次投影計算,淘汰次數卻從 11 增加到 22。
我們快取的是什麼
沿用前面的未訓練雙層 NumPy 解碼器:隱藏維度 16,float64,詞表 32,固定權重種子 7、11、23。它用來檢查計算等價性,不生成自然語言,也不代表 Agnes 的推理引擎。
在第 4、8 個 Token 後可以保存完整前綴檢查點。一個檢查點包含每層的 K、V、絕對位置陣列,以及繼續計算的位置。不同檢查點持有自己的陣列副本,沒有共享底層頁。
每個 Token 在持久陣列中的位元組數為:
2 層 × (K: 16×8 + V: 16×8 + position: 8) = 528 位元組
4 Token 檢查點 = 2,112 位元組
8 Token 檢查點 = 4,224 位元組
同一前綴的兩個檢查點合計 = 6,336 位元組
預算使用陣列真實的 nbytes 計算,不用“最多兩條記錄”代替記憶體約束。但這個數字不是行程記憶體:不包含 Python 物件、Token 鍵、模型權重、活躍請求的臨時陣列或 NumPy 內部工作區。
固定訪問順序,才能解釋命中率
每條軌跡有 12 個請求,每個請求 12 個 Token。末尾 Token 會變化,前 8 個由軌跡決定:
| 軌跡 | 請求順序 | 想驗證的問題 |
|---|---|---|
| 單一熱點 | 相同前 8 Token,同一作用域 | 快取裝得下時能否持續命中 |
| 兩分支交替 | 兩組不同前綴輪流出現 | 容量是否足夠容納工作集 |
| 三作用域輪轉 | Token 相同,作用域依次為 A/B/C | 隔離後是否仍然裝得下 |
預算分別為 4、8、32 KiB。3 個權重種子 × 3 個預算 × 3 條軌跡 × 12 次請求,共 324 次請求。
作用域使用合成字串,是快取鍵的一部分,不是使用者認證。相同文本屬於不同作用域時故意不重用,避免把“文本一樣”誤當成“可以共享”。
一次查詢如何執行
- 驗證 Token,計算模型與配置簽名。
- 在同一作用域、相同簽名的記錄中找最長完整前綴。
- 將命中的檢查點複製給當前請求,更新最近使用順序。
- 從命中位置繼續分段計算;到達新的檢查點邊界時嘗試保存。
- 太大的單個檢查點直接跳過;否則先淘汰最久未用的記錄,再保存副本。
查找只重用嚴格短於當前請求的檢查點,因此本輪總能返回至少一個新的狀態。本次請求長度固定為 12,保存邊界為 4 和 8。它不是按頁共享的 PagedAttention 實現,也沒有滑動視窗驅逐後的局部重建。
核心容量條件是:
cost = sum(array.nbytes for layer in checkpoint['layers'] for array in layer)
while resident_bytes + cost > budget:
    evict_least_recently_used()
save_owned_copy(checkpoint)
resident_bytes 限制的是長期保留檢查點的陣列總和。當前查詢仍可能臨時構造完整 K/V,這個限制不能直接拿去防止行程 OOM。
把首次填充也算進去
兩層模型中,每個新 Token 需要 Q、K、V 三組投影,所以完整請求計為 2 × 3 × 12 = 72 個投影行。12 次完整重算是 864 行。以下計數在三個種子上相同;種子改變數值結果,不改變請求順序和張量形狀。
| 預算 | 軌跡 | 命中 / 12 | 全軌跡投影行 | 淘汰次數 | 顯式檢查點複製位元組 |
|---|---|---|---|---|---|
| 4 KiB | 單一熱點 | 11 | 600 | 0 | 25,344 |
| 4 KiB | 兩分支交替 | 0 | 864 | 11 | 25,344 |
| 4 KiB | 三作用域輪轉 | 0 | 864 | 11 | 25,344 |
| 8 KiB | 單一熱點 | 11 | 336 | 0 | 52,800 |
| 8 KiB | 兩分支交替 | 0 | 864 | 22 | 76,032 |
| 8 KiB | 三作用域輪轉 | 0 | 864 | 22 | 76,032 |
| 32 KiB | 單一熱點 | 11 | 336 | 0 | 52,800 |
| 32 KiB | 兩分支交替 | 10 | 384 | 0 | 54,912 |
| 32 KiB | 三作用域輪轉 | 9 | 432 | 0 | 57,024 |
例如 8 KiB 熱點組:第一輪冷啟動計算 72 行,後 11 輪各命中 8 個 Token,只計算剩餘 4 個,即 72 + 11 × 24 = 336。
“複製位元組”只統計程式碼中顯式的檢查點保存和命中取出,不包括解碼器內部拼接、底層庫搬運,也不等於實際記憶體帶寬。
為什麼更大的預算反而淘汰更多
8 KiB 能同時保存一組前綴的 4 Token 和 8 Token 檢查點,共 6,336 位元組。但兩個分支需要 12,672 位元組。
從 A 換到 B 時,先保存 B4,再保存 B8,A4/A8 會相繼被淘汰。下一次回到 A,同樣重新計算、保存和淘汰。整個過程中,快取一直在工作,卻沒有一次命中。
4 KiB 只允許保存 4 Token 檢查點,每次切換只淘汰一條;8 KiB 每次保存兩條,因而發生兩次淘汰。這裡增加容量沒有跨過工作集閾值,增加的檢查點反而制造更多管理工作。
這不證明“快取越大越差”,也不是所有 LRU 的普遍定理。它說明:在這個保存策略和訪問軌跡下,記錄數量、記錄大小和重用距離需要一起考慮。 固定只保留最長檢查點、按重用價值準入或共享前綴,都可能改變結果,必須另做對照。
結果等價性不能省略
每次快取路徑返回的後綴狀態,都與同種子完整重算的對應位置比較。歸檔保存了 648 個陣列,324 項最大絕對誤差均低於 1e-12,實際最大值約 4.16e-16。
獨立審計還會按請求順序重建 LRU,逐項核對命中長度、淘汰記錄、駐留位元組和複製計數。7 個單元測試覆蓋零預算、作用域隔離、權重變更、陣列所有權、短查詢、輸入驗證和每 Token 位元組計算。
只報告命中率卻不驗證輸出,很容易把錯誤重用當成優化。反過來,數值等價也不說明優化值得:8 KiB 交替組完全正確,但沒有節省投影計算。
從這個實驗能推到哪里
可以確定的是,這個小模型在凍結訪問軌跡下,預算與工作集共同決定重用收益。不能推斷的是生產模型的每秒 Token 數、GPU 顯存占用、首 Token 延遲或成本下降。
Transformers 的 KV cache 文檔可作為理解不同快取策略的背景;本文所有計數來自本倉庫的 NumPy 實驗,不是對該庫實現的基準測試。模型簽名哈希、查找和 Python 管理也沒有計時,所以不能把 864 / 336 寫成實際加速倍數。
重現入口
python -m unittest discover -s experiments/08-cache-budget -p test_cache.py
python experiments/08-cache-budget/run.py --out experiments/08-cache-budget/evidence/my-run
python experiments/08-cache-budget/audit.py experiments/08-cache-budget/evidence/my-run
原始記錄包含 results.json、arrays.npz、原始碼與檔案哈希;audit.json 給出逐軌跡匯總。圖表從這些結果生成,沒有用擬造的曲線補趨勢。
下一步有意義的優化是比較保存哪些檢查點,並測量查找、複製、計算的端到端時間。當前先得到一個更可靠的判斷方式:快取是否有效,要看冷啟動後的完整工作負載,而不是挑一次漂亮的命中。
寫給未來的自己合上文章前,留下一點自己的理解。
你的私人學習便箋,只存在目前瀏覽器,不會上傳或公開。清理瀏覽器資料會遺失,請匯出留存。三種語言共用這篇文章的便箋。
下一篇已發布內容:LLM 機制實驗(七):快取省了計算,為什麼實測反而更慢? →
目前學習位置
理解 / LLM
- ○ LLM 機制實驗(五):改了歷史,能否只重算變化的後綴?
- ○ LLM 機制實驗(六):快取加大了,為什麼還是一次都沒命中?
- ○ LLM 機制實驗(七):快取省了計算,為什麼實測反而更慢?
繼續探索
繼續探索
接下來,走哪條路?
- LLM 機制實驗(五):改了歷史,能否只重算變化的後綴? →
27 個固定條件、81 個原始數組,驗證最長相同前綴裁剪、位置同步、滑窗回退與作用域隔離。
- LLM 機制實驗(四):前綴改了,舊 KV Cache 還能繼續用嗎? →
三種子、六條件,比較錯誤重用與帶鍵校驗的前綴快取;數值相同也不代表允許跨作用域共享。
依據文章關聯與同主題已發布內容整理,不使用隨機推薦。