

學習 / 實作
LLM 機制實驗(七):快取省了計算,為什麼實測反而更慢?
llm / 理解 · 機制拆解
4860次實測查詢比較三種快取準入策略,把位元組預算、工作集、計算量與本地耗時放在一起驗證。
這篇之後,已經有了哪些結果?
保留本文發表時的結論與下一步構想;以下是已發布的後續內容,不代表所有侷限皆已解決。
繼續探索
繼續探索
瀏覽統計暫不可用
本文目錄 9
上一輪發現,8KiB 快取遇到兩個輪流訪問的前綴,會發生零命中的反覆淘汰。自然的下一步是少存一些檢查點,把容量留給真正有用的前綴。
這次同時測量計算量和耗時。結果並不等於“快取優化成功”:準入策略改善了某些訪問軌跡,但在這個小型 NumPy 模型上,快取查詢仍然比直接重算慢。
先分清三個問題
| 要回答的問題 | 本系列怎樣檢查 | 能得出的結論 |
|---|---|---|
| 結果是否等價? | 相同輸入下比较快取續算與完整重算陣列,誤差門檻固定 | 本模型與精度下數值一致,不證明語義品質 |
| 計算是否減少? | 統計實際 Q/K/V 投影行數 | 少做了這些投影,不等於全部運算等比例減少 |
| 使用者是否等得更短? | 計時完整查詢,保留無快取基準與重複結果 | 本機與這組負載的時間,不能外推生產 LLM |
命中有效前綴 → 少投影一些 Token ─┐
簽名、查找、複製、分段呼叫 ─────┼→ 查詢總耗時(必須測量)
未命中時仍要重算 ─────────────┘
三 scope / 16KiB 是具體反例:longest 比 all 少算一半投影行,卻仍比 none 慢。兩個比較對象都要保留,不能只選較慢的快取基準來宣稱加速。
小練習:864 行降到 432 行,能否說「快了 50%」?
不能,只有投影行數減少 50%。相應中位數為 6.723ms,無快取為 1.697ms。檔案讀取、雜湊和複製均在計時內,但尚未分段剖析,不能認定其中某一項是主要瓶頸。
本篇只改變保存哪些檢查點
模型仍為兩層、維度 16、詞表 32 的未訓練 Decoder,輸入長度為 12 個 Token。前八個 Token 是可重用前綴,後四個是變化的後綴。我們比較三個策略:
| 策略 | 保存內容 | 下一次查詢 |
|---|---|---|
none |
不保存 | 完整重算 12 個 Token,不做快取簽名和複製 |
all |
第 4、8 個 Token 處的完整前綴 | 查找最長可用前綴,再續算 |
longest |
只保存第 8 個 Token 處的完整前綴 | 使用相同查找、分段計算和 LRU 邏輯 |
all 和 longest 的差異是準入;後者即使不保存第 4 個檢查點,也仍沿用相同分段計算路徑。none 則是實際的無快取基線,不為了形式一致而額外做它不需要的哈希或分段工作。
快取條目分別擁有完整的 K、V、位置陣列,沒有共享前綴頁。因此每 Token 的持久陣列負載是 528 位元組,四 Token 為 2,112 位元組,八 Token 為 4,224 位元組。這裡的容量不是行程記憶體或 GPU 顯存。
容量計算能預測什麼,不能預測什麼
三個隔離 scope 分別保留兩個檢查點,需要:
all:      3 × (2,112 + 4,224) = 19,008 bytes
longest:  3 × 4,224           = 12,672 bytes
16 KiB:                       16,384 bytes
因此 16KiB 能容納三個最長檢查點,卻放不下三組全部檢查點。scope 不同的條目即使 Token 相同也不共享,不能為了增加命中率破壞隔離。
但“全部檢查點放不下”不一定表示零命中。12KiB 雙分支的 all 組只發生一次淘汰:丟掉較短且之後不需要的檢查點,仍保住兩個長前綴,後續命中十次。容量算式提供上界,實際收益還要看訪問順序和淘汰後的狀態。
測量邊界:到底把什麼算進了耗時
3 個種子 × 3 個預算(8、12、16KiB)× 3 條訪問軌跡 × 3 種策略,共 81 個配置。每個配置先完整預熱一次;隨後執行五次測量,每輪隨機交錯配置順序,每條軌跡都從新的模型物件和空快取開始。
正式記錄為 405 條軌跡、4,860 次請求;預熱另有 972 次請求,不並入統計。每個“預算/軌跡/策略”的耗時匯總含 3 種子 × 5 重複,共 15 條軌跡。
start = time.perf_counter_ns()
states, info = store.query(scope, model, tokens)
elapsed_ns = time.perf_counter_ns() - start
# 參考計算放在計時區外,但仍逐請求驗證數值一致性。
fresh, _ = model.full(tokens)計時覆蓋簽名校驗、查找、陣列複製、模型計算、準入和淘汰。不包括模型構造、參考重算、結果序列化和繪圖。特別要注意:沿用的簽名函數每次會讀取模型源檔案並哈希模型權重,這個檔案讀取也包含在查詢耗時里。這不是已經優化過的生產快取實現。
perf_counter_ns() 返回整數納秒,適合記錄時間差;納秒單位不代表測量具備納秒精度。Python 時間 API
16KiB 下:計算量減少,時間沒有跟著下降
下表均為一條 12 請求軌跡,包含首次冷快取請求。耗時為 15 條實測軌跡的中位數,括號是最小—最大範圍。
| 訪問軌跡 | 策略 | 命中 | Q/K/V 投影行 | 查詢總耗時(ms) |
|---|---|---|---|---|
| 單一熱點 | none | 0 | 864 | 1.646(1.607—3.260) |
| 單一熱點 | all | 11 | 336 | 5.921(5.680—6.886) |
| 單一熱點 | longest | 11 | 336 | 6.231(5.679—8.648) |
| 兩個前綴交替 | none | 0 | 864 | 1.733(1.603—3.511) |
| 兩個前綴交替 | all | 10 | 384 | 6.495(6.036—9.840) |
| 兩個前綴交替 | longest | 10 | 384 | 6.282(5.846—7.138) |
| 三個隔離 scope | none | 0 | 864 | 1.697(1.612—2.126) |
| 三個隔離 scope | all | 0 | 864 | 10.263(9.255—15.599) |
| 三個隔離 scope | longest | 9 | 432 | 6.723(6.345—10.020) |
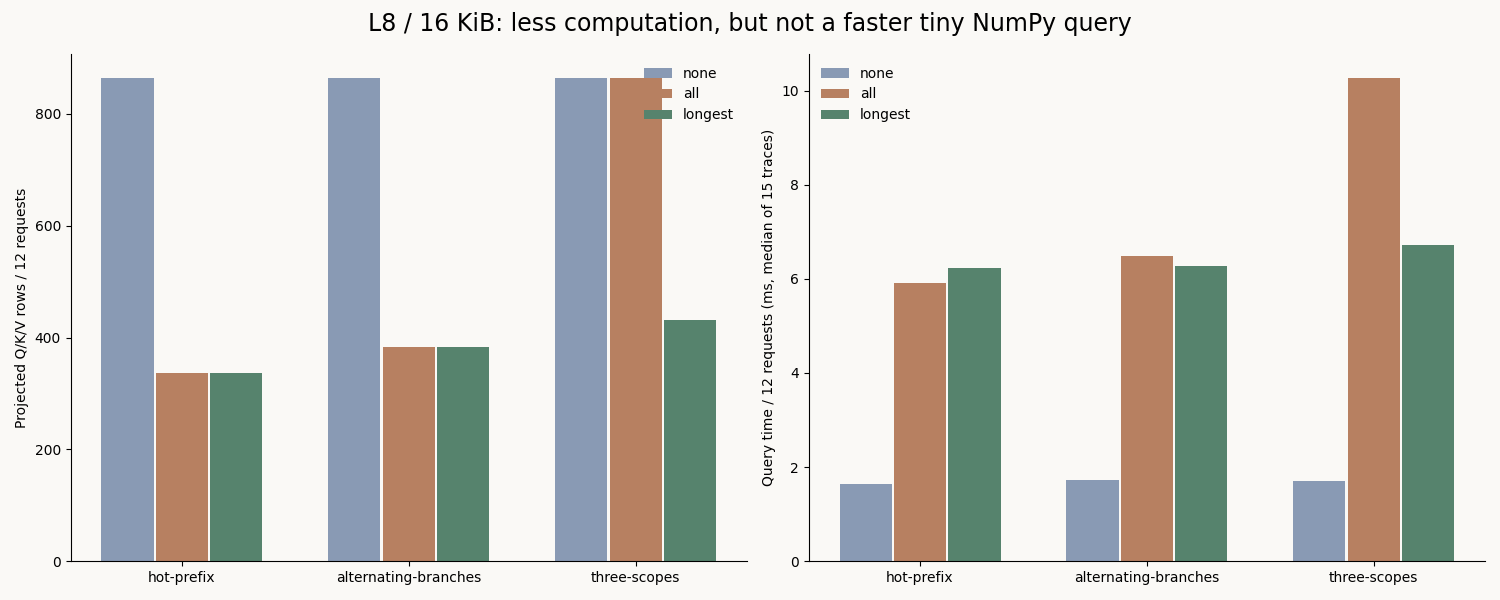
三 scope 組是準入變化最有解釋力的對照:all 淘汰 20 次,longest 淘汰零次,投影行由 864 降到 432,查詢時間中位數也由 10.263ms 降到 6.723ms。但無快取基線只需 1.697ms,因此不能把相對另一種快取策略的改善說成相對直接重算的加速。
熱點組也沒有“只存最長必然更快”:兩種快取策略都命中十一回,最長組的中位數反而略高,範圍明顯重疊。沒有統計顯著性分析,也沒有對某次更快的運行挑選展示。
為什麼會出現這種結果
這裡的模型很小,矩陣運算成本低。快取路徑卻必須維護簽名、Python 容器、完整前綴副本和多個分段呼叫。無快取路徑直接完成一次完整計算,省去了這些管理步驟。
這是程式碼路徑與結果共同支援的解釋,不是各項開銷的定量歸因:本輪沒有分別計時哈希、複製與矩陣計算,不能聲稱某一項占比多少。下一輪可以先剖析,再比較“模型加載時固定版本簽名”和“每次重新計算簽名”,同時保留模型變更失效測試。
不能直接刪除簽名來換速度。若權重或位置編碼規則變化後仍沿用舊 K/V,較快地返回錯誤結果並不是優化。
兩個應當保留的失敗條件
8KiB 的雙分支仍然零命中。 兩個最長前綴需要 8,448 位元組,超過 8,192 位元組。longest 把淘汰次數從 22 降到 11,複製負載從 76,032 降到 50,688 位元組,卻沒有節省投影計算。
12KiB 的三 scope 也仍然零命中。 三個最長前綴需要 12,672 位元組,超過 12,288 位元組。規則改得再簡潔,也不能抹去工作集與容量的關係。
這些固定軌跡沒有取樣真實使用者流量。表中的命中數量用於說明機制,不是線上快取命中率預測。
從哪裡開始,怎樣重現
初次閱讀可依序看 容量與機制、等價性、失效、最長前綴、位元組預算。這些是已完成的離線數值實驗。
另一條支線為 24 次 Agnes 3.0 真實呼叫;後續的 128 項相似干擾方案僅完成離線準備,沒有新模型結果,不能混入本篇分母。
在新目錄準備 Python 3.12 環境(PowerShell):
git clone https://github.com/VirtualSelect/hohoo-ai-lab.git hohoo-ai-lab-cache
cd hohoo-ai-lab-cache
git checkout 503f5271ef0d5baa12353d6eeda672dec5fc240e
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install numpy==2.2.6
cd experiments/09-cache-admission
..\..\.venv\Scripts\python.exe -m unittest discover -s . -p test_cache.py
..\..\.venv\Scripts\python.exe run.py --out evidence/my-run
..\..\.venv\Scripts\python.exe audit.py evidence/my-run
預期得到逐請求記錄與陣列。先查誤差、投影行與預算,再看時間分布。輸出目錄必須不存在;時間不必與封存逐位相同,超過協議誤差門檻才是正確性問題。缺少 NumPy 時確認安裝與執行使用同一解譯器。
稽核範圍: 現有腳本校驗結果檔案雜湊並獨立重算部分指標,但不會遍歷 manifest.sources 核對原始碼。因此仍須固定上述提交;不能將稽核通過解讀為原始碼、環境與生產效能皆獲證明。
附錄:數值校驗與封存結構
所有 4,860 次查詢都與完整重算比較,最大絕對誤差約 4.16 × 10⁻¹⁶。每個配置的首次測量還保存參考與重用兩個陣列,共 1,944 個陣列,便於獨立復算;後四次保存誤差和時序,不重複歸檔陣列。
六組邊界測試覆蓋非法策略、容量相差一位元組、scope 隔離、模型身份變更、返回值與快取記憶體隔離,以及只準入最長檢查點。獨立審計按 Token 與 scope 重放 LRU,不呼叫被測 Store 來判斷結果。
需要項目既有的 Python/NumPy 環境;歸檔使用 Python 3.12.14、NumPy 2.2.6。manifest.json 保存凍結程式碼版本、環境、NumPy 配置、計時器分辨率與哈希;results.json 保留請求順序、耗時、計算計數、複製位元組和淘汰事件。
本輪不是專用基準機測量,沒有 CPU 綁核、GPU 或真實模型推理;重複運行的時間會變化。它給出的可遷移結論是:同時報告正確性、容量、工作量和真實耗時,才能判斷一個快取優化究竟優化了什麼。
修復進展 · 2026-10-07
2026-10-07 修正:稽核現在逐項校驗 manifest.sources,拒絕原始碼變更、缺失檔案或越界路徑。舊 4,860 次查詢與耗時保持原樣;本次原始碼一致性回歸不提供新的快取效能結論。
寫給未來的自己合上文章前,留下一點自己的理解。
你的私人學習便箋,只存在目前瀏覽器,不會上傳或公開。清理瀏覽器資料會遺失,請匯出留存。三種語言共用這篇文章的便箋。
下一篇已發布內容:把答案放在上下文中間,模型就會漏掉嗎?一次提前停止的對照試驗 →
目前學習位置
理解 / LLM
- ○ LLM 機制實驗(六):快取加大了,為什麼還是一次都沒命中?
- ○ LLM 機制實驗(七):快取省了計算,為什麼實測反而更慢?
- ○ 把答案放在上下文中間,模型就會漏掉嗎?一次提前停止的對照試驗
繼續探索
繼續探索
接下來,走哪條路?
- LLM 機制實驗(六):快取加大了,為什麼還是一次都沒命中? →
27 條冷啟動軌跡、324 次請求與 648 個陣列,按位元組限制前綴檢查點,觀察工作集、隔離與 LRU 淘汰的實際收益。
- LLM 機制實驗(四):前綴改了,舊 KV Cache 還能繼續用嗎? →
三種子、六條件,比較錯誤重用與帶鍵校驗的前綴快取;數值相同也不代表允許跨作用域共享。
依據文章關聯與同主題已發布內容整理,不使用隨機推薦。